目錄9 節
先說一個我在工作坊裡看過太多次的畫面。
學員打開 Gemini Notebook,把五篇 PDF 拖進去,按下產生語音摘要,兩個虛擬的男女人物開始一搭一唱地聊那五篇論文。學員聽得很開心,覺得這工具真神奇。然後呢?沒有然後了。下一次要寫文獻探討時,他還是得打開 Word,對著空白的頁面發呆。
問題不在工具,而在於很多人把它當成摘要的工具。摘要是它最基本的功能,你拿到的是一段讓你覺得自己好像懂了的內容,但那不會變成論文裡的任何一句話。
它真正值錢的地方,其實是另一件事:它讓你擁有一個有邊界的語料庫,而且這個語料庫可以被追問。邊界是你自己畫的,答案只能從你放進去的東西長出來,每一句回答都附著可以點回原文的引用。這跟你去問一個什麼都讀過、但也什麼都可能編的通用模型,是兩種完全不同的工作。
我想藉由這篇文章,跟你談談怎麼把那個語料庫,變成研究流程裡真的會被用到的東西。
這篇長文另有一份 100 頁的教學簡報版本,適合課堂投影或一頁一頁翻:《Gemini Notebook 學術用法指南》。
先確認你用的是哪一個版本
寫這篇文章的時候,有三件事已經跟半年前不太一樣了,值得先對齊。
Google 已於 2026 年 7 月 16 日把 NotebookLM 正式更名為 Gemini Notebook,並把網址換成 notebook.google.com,舊網址現在會轉址過去。官方同時公布它已有超過三千萬名使用者與六十萬個組織在用,並宣布加入可原生執行程式碼的沙箱環境來做資料分析(Google 官方公告)。所以你在網路上看到的教學文,只要還在講 NotebookLM 與舊網址,基本上就是一年前的資訊,功能對照表要重新看過。它這一路的功能演進,我在《Gemini Notebook 進化指南:從筆記工具到語音學習教練,打造你的 AI 智慧工作室》整理過一輪,這篇就不重複,直接談研究場景。
它的額度分級,也跟很多人記憶中的印象有所不同。以官方 2026 年 9 月的使用限制頁為準,免費版是每本筆記本 50 個來源、最多 100 本、每天 50 次提問、每天 3 則語音摘要;AI Pro 則拉到每本 300 個來源、500 本、每天 500 次提問。單一來源的上限是 50 萬字或 200MB,這個數字不會因為你付費而變大,它是所有方案共用的天花板。
嗯,還有一件對研究生特別有意義的事:Google 在 2026 年 9 月宣布美國以外的 140 多個市場提供大學生免費一年的 AI Plus 方案,兌換期限是 2026 年 12 月 31 日(官方公告)。如果你有學校信箱,這件事值得今天就去查一下你的資格,因為免費版每天 50 次提問,做文獻工作大概兩個小時就會用完。
它做得到什麼,做不到什麼
老實說,這一段比操作步驟重要。工具教學最常見的災難,是帶著錯誤期待回家,然後卻在自己的電腦前面卡住。
做得到的事情有三件:
把答案限制在你的來源裡。它的設計是來源導向,回答會附上引用標記,點下去會跳到原文那一段。這是它跟通用聊天模型最根本的差別,也是研究者該把它放進流程的唯一理由。
在來源之間做橫向比較。三十篇論文丟進去,你可以問哪幾篇的測量方式不一樣、哪些研究彼此矛盾、哪一個概念被幾種不同的定義使用過。這是人腦最吃力、而它最擅長的工作。
把同一批材料換成不同的形態。語音摘要現在有四種格式,除了預設的深度對談之外,還有精簡版、辯論版與批判版;另外還有影片摘要、心智圖、測驗卷、學習指南與簡報大綱(官方說明)。同一批文獻用四種形態過一遍,記得住的東西差很多。
做不到的事情有四件,而且短期內可能不會改變:
它不會替你找文獻。雖然它有 Discover sources 可以代為搜尋網路,但那是網路搜尋,不是學術資料庫檢索,沒有 DOI 層級的驗證。真正的文獻搜尋該交給誰,我在《找文獻為什麼該用 AI Agent,而不是把 ChatGPT 當圖書館》裡寫過完整的理由。
它的引用可追溯,但不保證正確。佛羅里達大學商學圖書館的指南講得很直接:來源標註提高了可追溯性,但不保證每一則摘要、詮釋或引用都是對的,重要資訊仍須核對原文(UF Business Library)。實證研究兩邊的證據都有:Tozuka 等人用 100 個虛構的肺癌分期案例測試,引用定位正確率 95%、判斷正確率 86%,表現優於當時的 GPT-4o(arXiv:2410.10869);但 Reuter 等人在《Eye》期刊的評論則指出,在臨床情境裡它的事實正確性與引用可驗證性仍有風險,導入前必須審慎測試(Nature: Eye)。兩份研究都不是拿來替它背書或定罪的,而是告訴你:它的錯誤率不是零,而你的名字會掛在論文上。
它不會替你做學術判斷。哪幾篇構成你的理論對話對象、你的研究缺口在哪、這個貢獻值不值得寫成一章,這些是研究工作的本體,不是可以外包的流程。
它的東西比較難匯出。目前沒有支援官方的 Zotero 或 Mendeley 匯出功能,筆記本也無法完整匯出成檔案。這個缺口怎麼補,後面我會專門講。
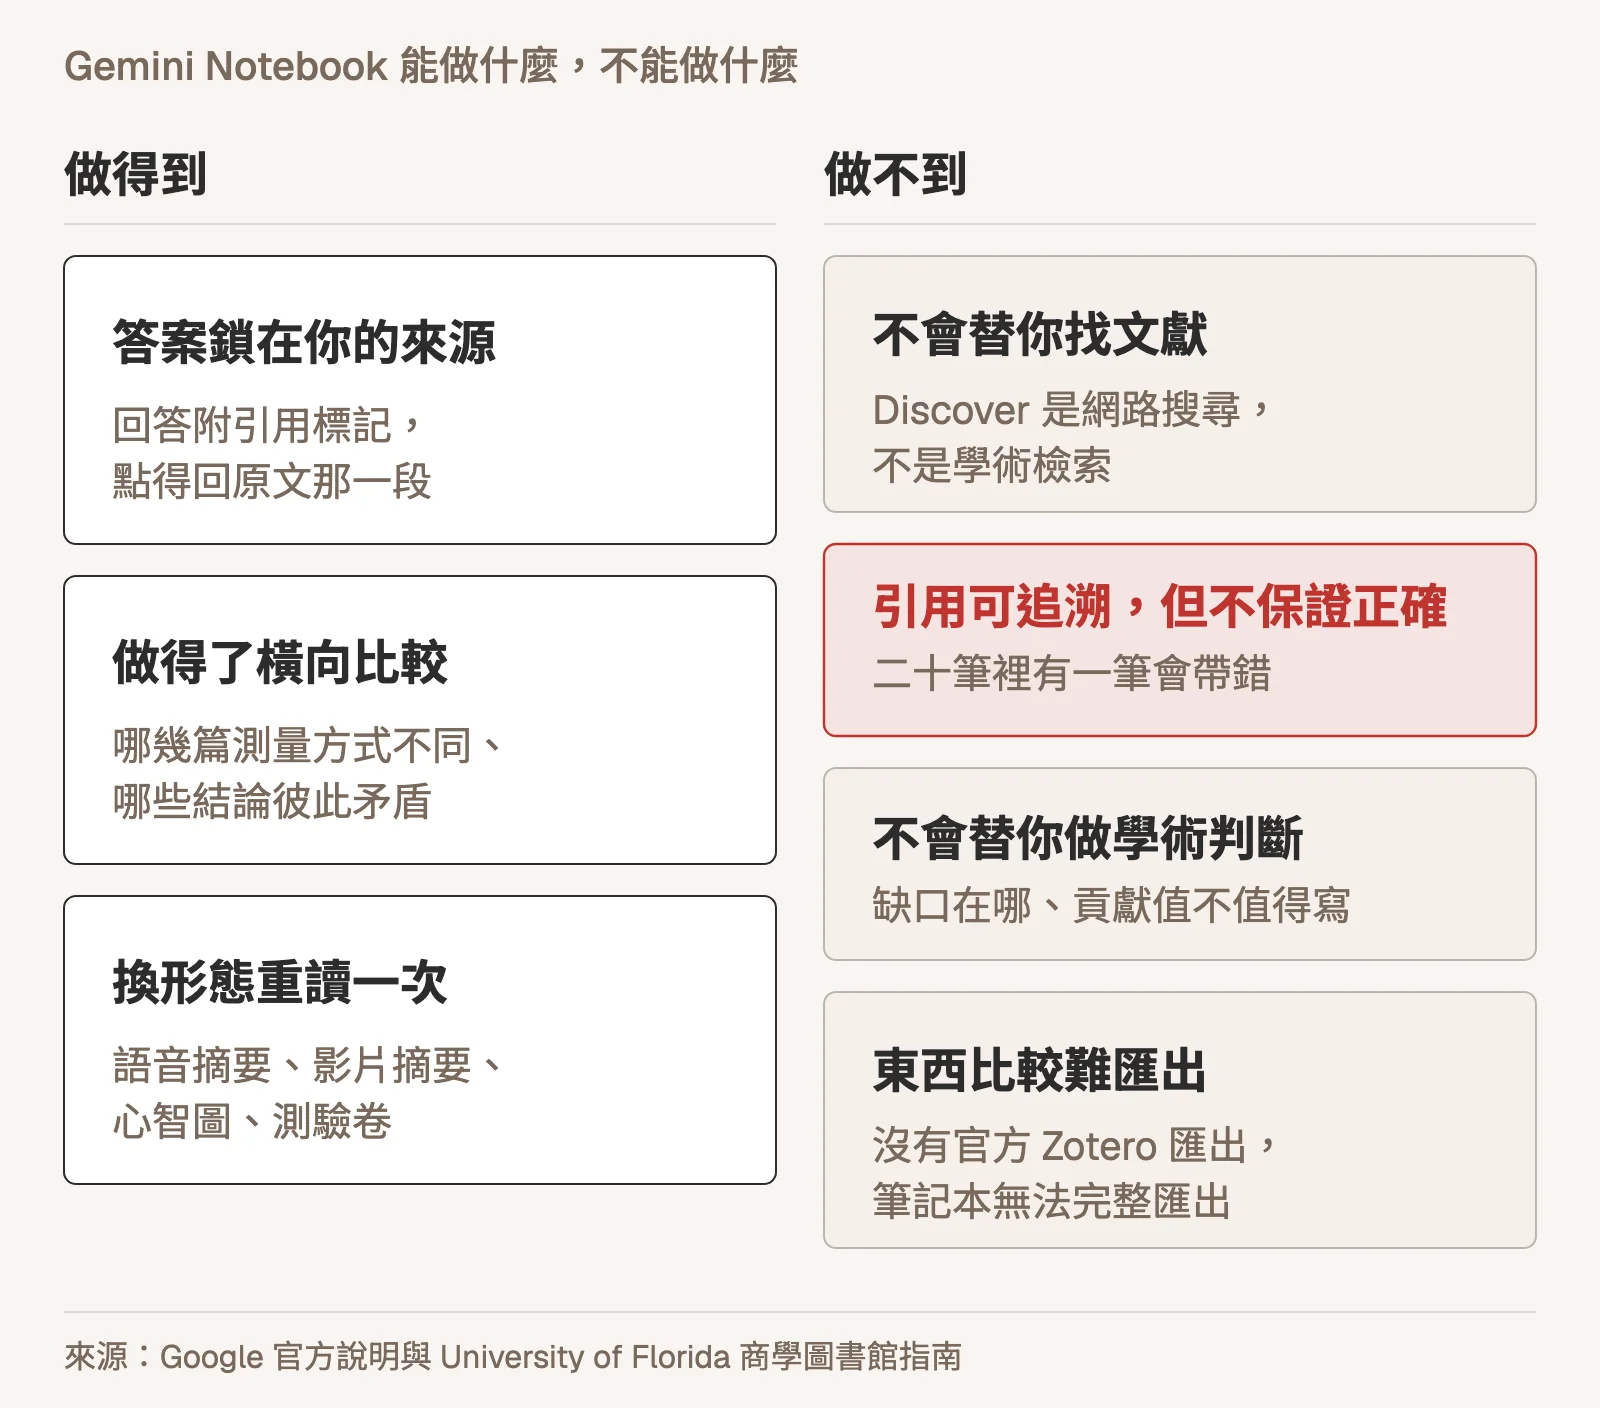
▲ 左邊那三件事值得學,右邊那四件事要早點知道,特別是紅色那一格
動手之前的三個決定
決定一:筆記本怎麼劃分
最常見的錯誤是開一本叫做「我的論文」的筆記本,然後把所有東西都丟進去。三個月後那本東西有 47 個來源,你問任何問題它都給你一段四平八穩的廢話。
有效的劃分方法,是一個筆記本對應一個你答得出來的問題。若以一本碩士論文為例,可以分成四本:理論對話對象(那 8 到 15 篇你真的要跟他們對話的核心文獻)、方法論(研究方法專書的相關章節、用同一方法的示範論文)、實證資料(你自己的逐字稿、問卷開放題、田野筆記)、投稿與規範(目標期刊的投稿須知、近三年該刊登過的同類論文、系上的格式規定)。
這樣劃分的好處在於,每一本的邊界都能回答一個具體的問題。理論那本回答「我的論點該站在誰的肩膀上、又要跟誰吵架」,方法那本回答「這個步驟我到底該怎麼做,才不會被審稿人抓到毛病」。邊界模糊的筆記本,答案也會跟著模糊。
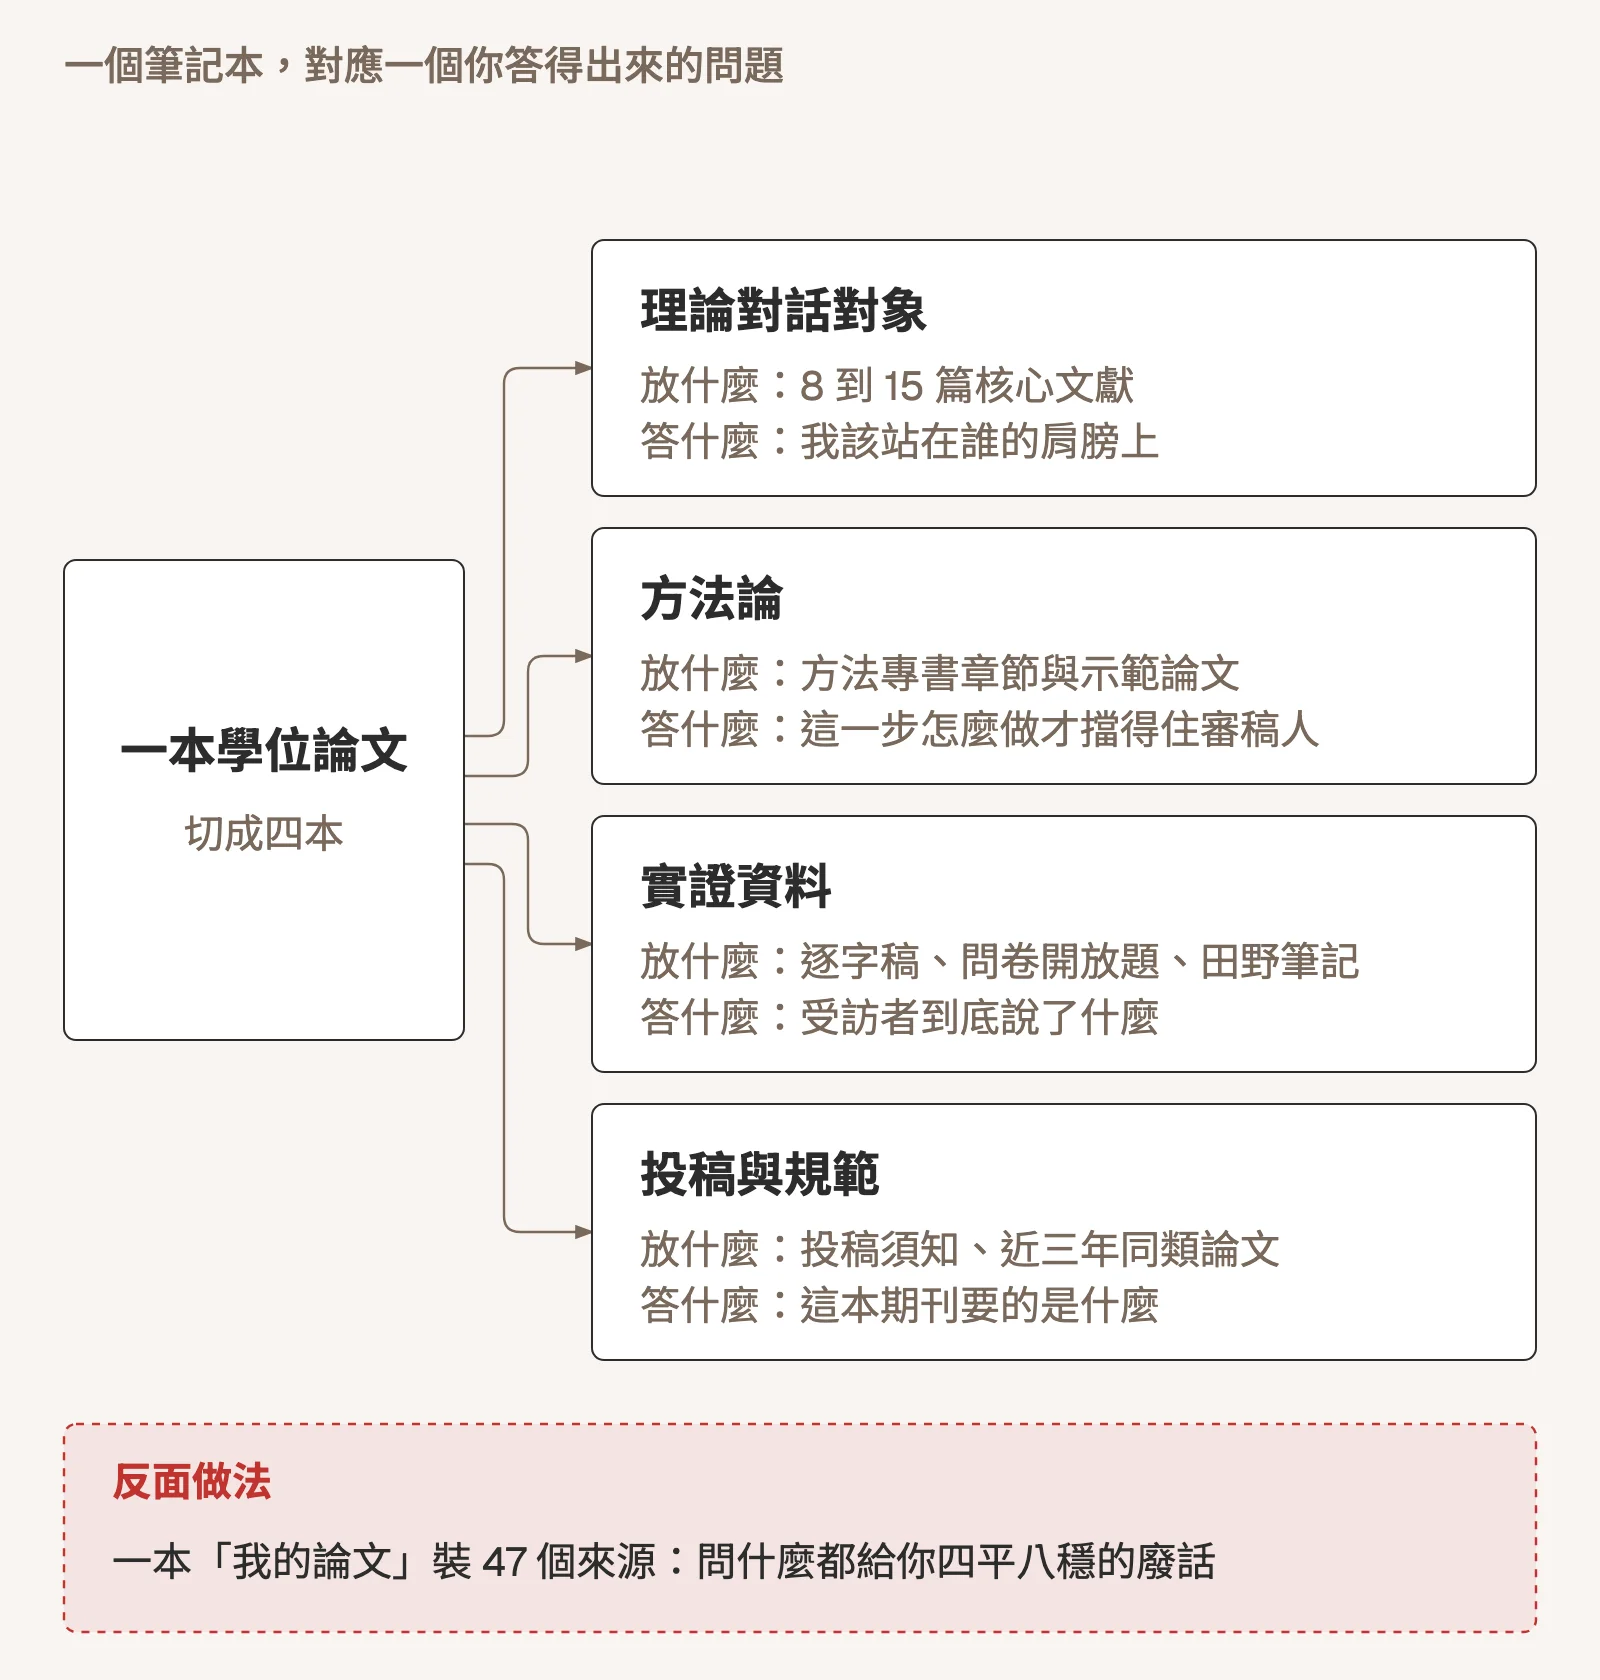
▲ 四本各自守住一個問題,比一本裝四十七個來源有用得多
決定二:來源怎麼選
它的上限是每本 50 到 300 個來源,但這是容量不是目標。文獻回顧筆記本放超過 20 篇,回答的平均化程度就開始明顯上升,因為模型會傾向找出所有來源的共通點,而共通點往往正是最沒有資訊量的部分。
比較好的做法,是分成兩層:核心層放 8 到 15 篇你真的讀過的文獻,外圍層另開一本放你還在篩的 30 篇。核心層用來產出你論文裡的句子,外圍層只用來做一件事,就是問「這 30 篇裡面,有哪幾篇跟我核心層那 10 篇處理的是同一個爭議」。篩完就升級進核心層,或者刪掉。
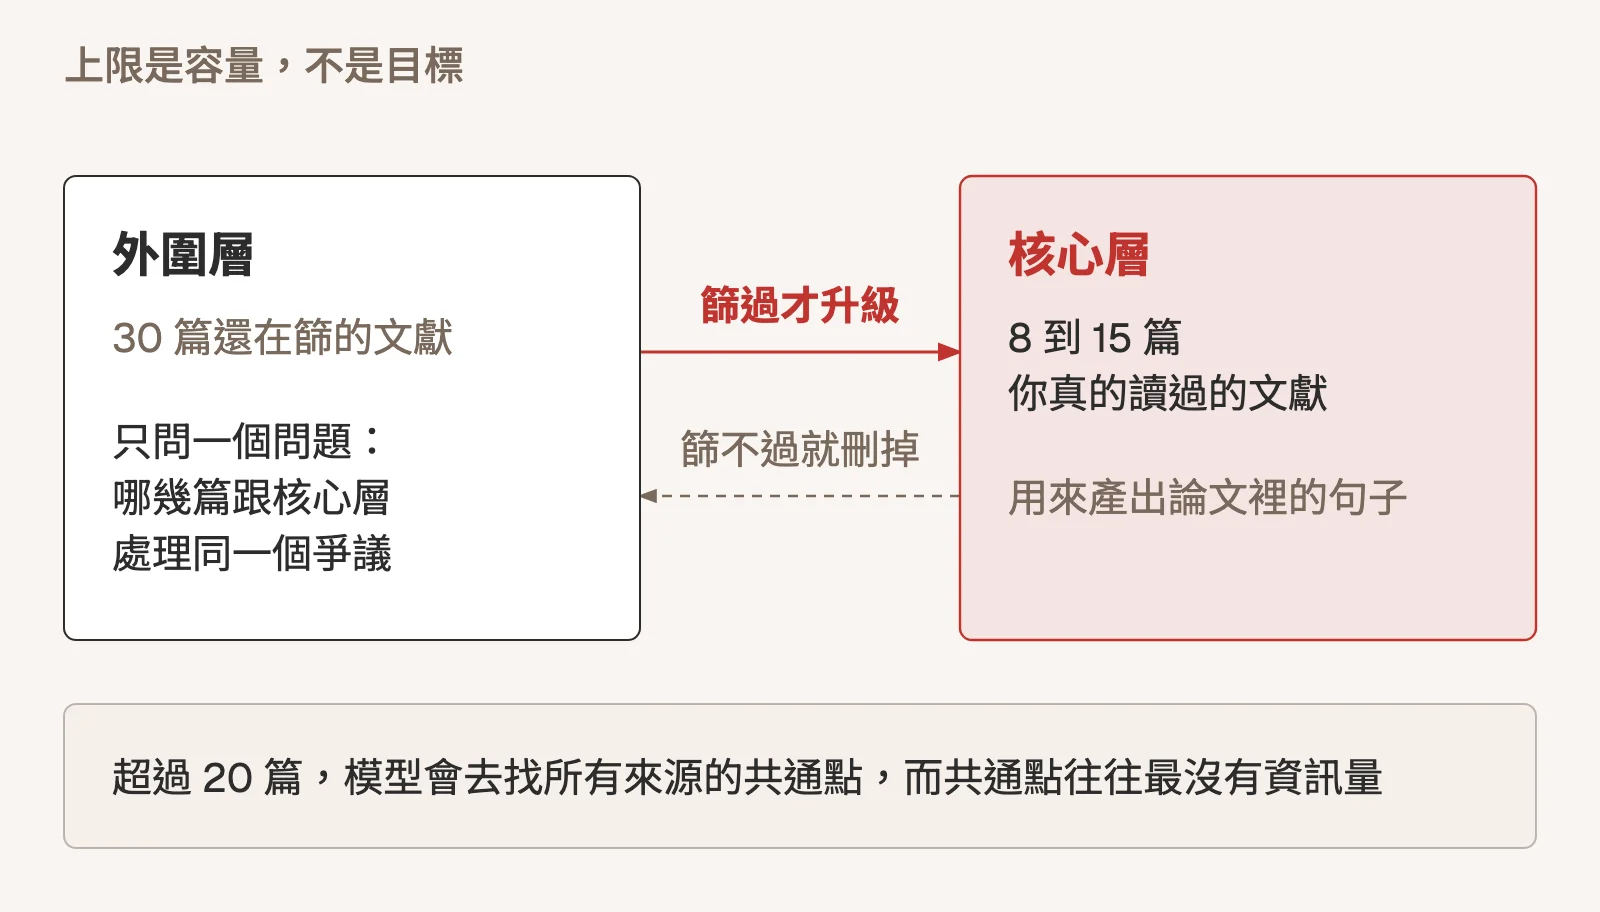
▲ 上限是容量不是目標:核心層決定你寫得出什麼,外圍層只負責被篩
另外一個實務細節:掃描版的 PDF 如果沒有文字層,它讀不出任何一個字,但不會報錯,只會給你一段空泛的回答。年代久遠的期刊論文、學位論文的掃描檔,丟進去之前請先確認你能不能在 PDF 裡選取文字。
決定三:哪些資料不能放進去
這一條請認真看,它牽涉的是研究倫理委員會與你的口試。
Google 官方的說法是,你在 Gemini Notebook 裡的內容不會被直接用來訓練基礎模型,除非你主動提供回饋。也就是說,你按下那個讚或倒讚的按鈕時,你的提問、自訂設定、來源檔案與輸出結果會一併送出,並由受訓人員審閱,保留最長三年(官方隱私說明)。
真正的分水嶺,其實是在帳號類型。Workspace 與 Workspace for Education 帳號,即使你給了回饋,資料也不會經人工審閱、不會用於訓練模型。而這件事跟你有沒有付錢無關:個人付費的 AI Pro 與 Ultra,在訓練政策上與免費版並無差別。很多人以為付費就等於買到了隱私,這是誤解。
所以,實務上的判斷標準是:
| 資料類型 | 建議 |
|---|---|
| 已出版的文獻、公開教材、你自己已發表的論文 | 任何帳號都可以放 |
| 未發表的稿件、投稿中的論文、申請中的研究計畫 | 用學校的 Workspace 帳號,且不要按回饋按鈕 |
| 受訪者逐字稿、可辨識個資、IRB 有保密承諾的資料 | 先回去看你的 IRB 同意書怎麼寫。同意書沒寫可上傳第三方雲端服務,就不要上傳 |
| 他人未發表的審稿稿件 | 絕對不要。你是審稿人,那份稿子不是你的 |
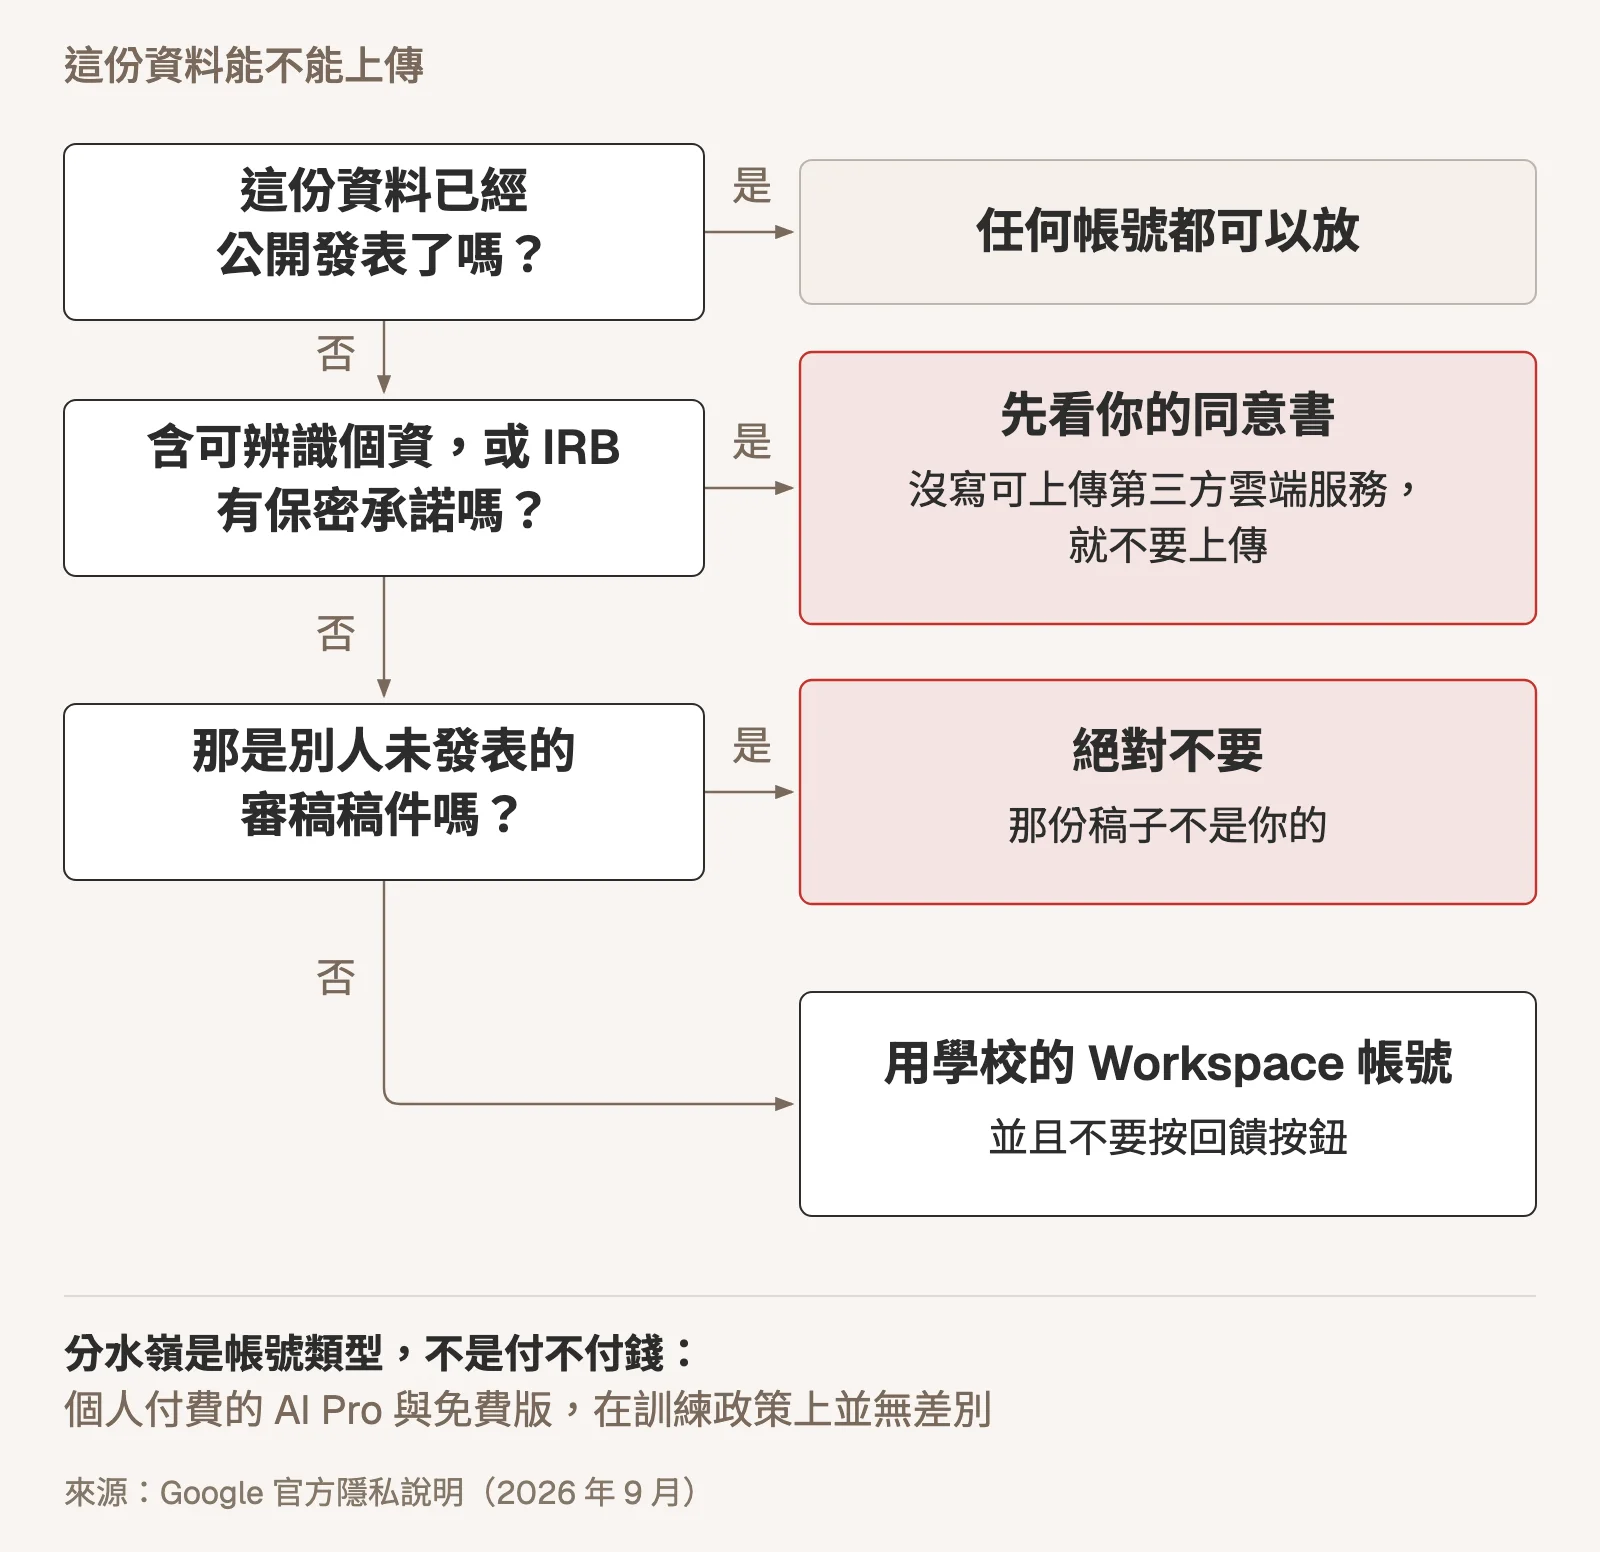
▲ 四個出口,兩個是紅燈。走到最後一格的資料,也要用學校帳號
對了,還有一個容易被忽略的洞:分享功能裡的 Chat View 模式看起來只給對方對話視窗、不給來源,但官方說明裡註明了,那只是把素材隱藏起來,並沒有真正撤銷檢視者對筆記本內容的底層存取權(官方分享說明)。所以不要以為切成 Chat View 就可以把含有保密資料的筆記本丟給別人看。
研究流程裡的五種用法
順帶一提,如果你想看的是課業與考試那一面的用法,《博碩士生的學習神器:如何善用 Gemini Notebook ,讓課業準備得以事半功倍?》那篇談得更細,這一節專講做研究。
以下每一種,我都附上了可以照抄的問法。這些問法的共同點是:都要求它指出出處、並允許它說沒有。這兩個約束是把它從聊天工具變成研究工具的關鍵。
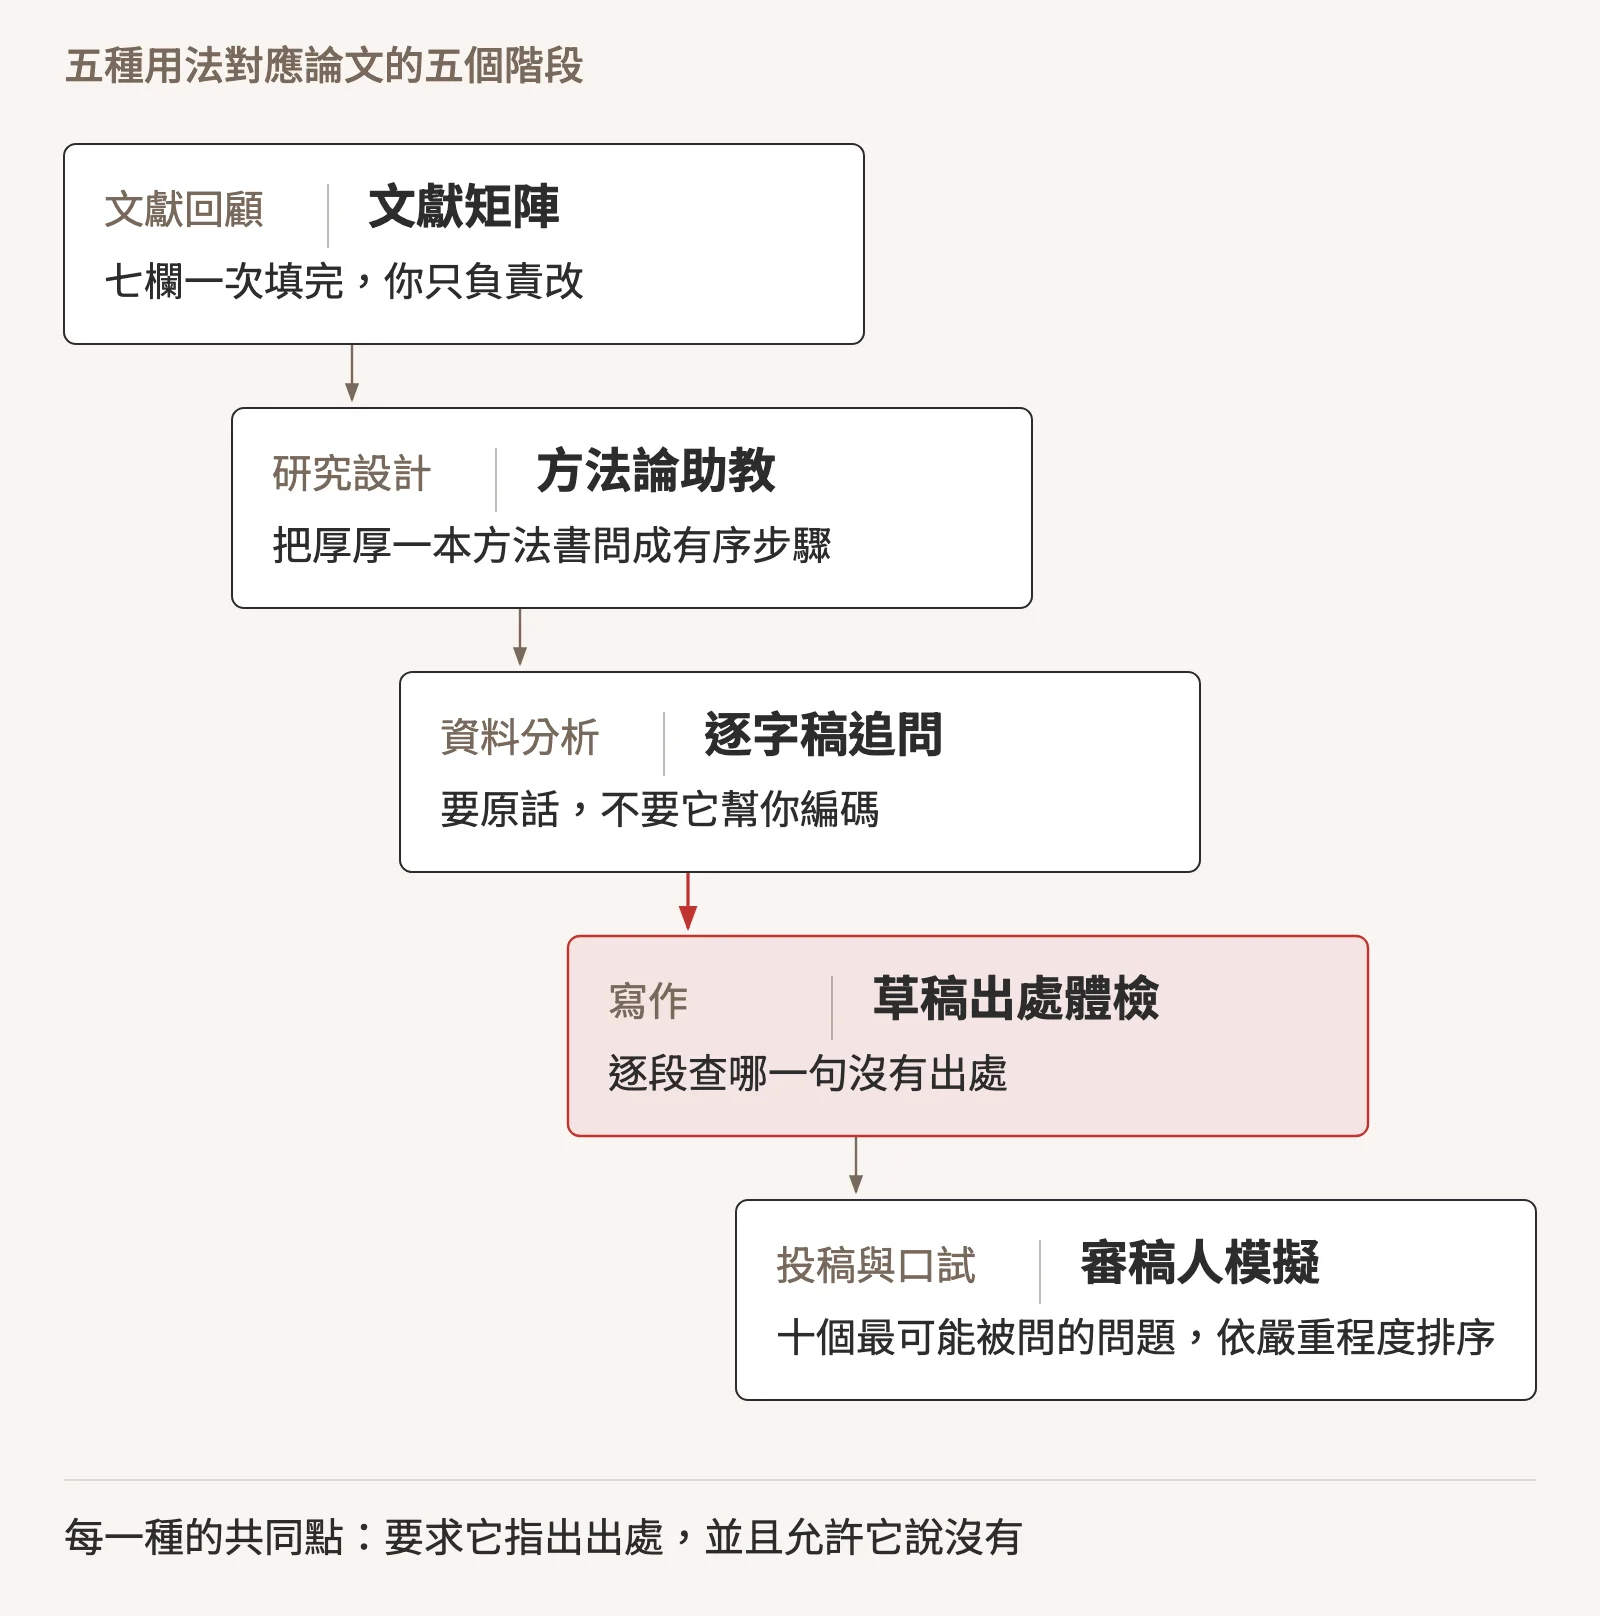
▲ 五種用法各自對著論文的一個階段,紅色那一格最少人做
一、文獻回顧:把一疊 PDF 變成一張矩陣
文獻矩陣是文獻探討的地基,做法我在《文獻探討到底在做什麼?》裡寫過。以前這張表要花兩個晚上手工填,現在可以先讓它填一版,你來改。
可以照抄的問法:
針對這個筆記本裡的每一篇文獻,輸出一個表格,欄位依序是:作者與年份、研究問題、理論框架、資料來源與樣本、主要測量方式、核心發現、作者自述的研究限制。每一格都要標註是根據哪一篇來源的哪個部分。任何一格如果在來源裡找不到明確說法,就填無法確認,不要推測。
這些文獻在測量同一個概念時,用了幾種不同的操作型定義?請依定義分組,列出每一組各有哪幾篇,並指出各組之間的差異在哪裡。
哪幾篇文獻的結論彼此衝突?請具體指出衝突的是哪一個論點,以及兩邊各自的證據是什麼。
這批文獻共同沒有處理的問題是什麼?請只根據來源裡作者自己提到的限制與未來研究建議來回答,不要自行推論研究缺口。
嗯,最後那一句的限制條件很重要。研究缺口的判斷是你的工作,它能做的只是把每位作者自己承認的限制彙整起來,讓你看見重疊的地方。缺口要不要寫成缺口,由你決定。
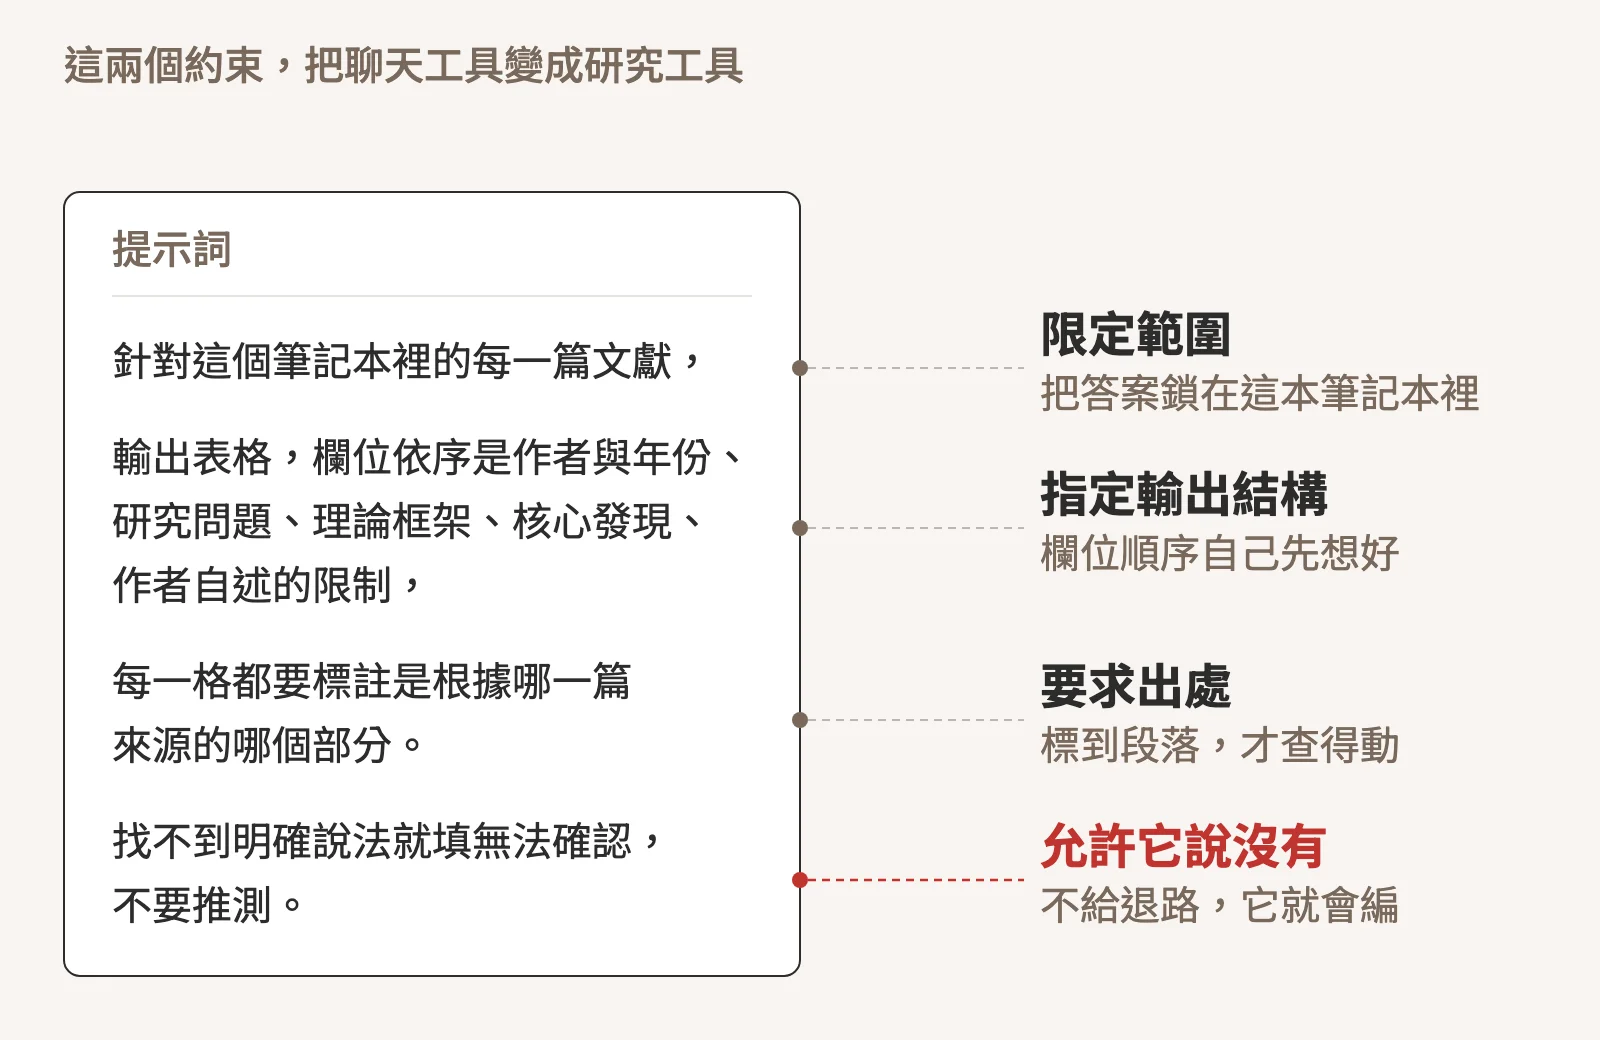
▲ 一個能用的問法,拆開來看就是這四個約束
二、方法論自學:把一本書變成一個可以問的助教
研究方法的專書最大的問題是它太厚,而你只需要其中的 30 頁,但你不知道是哪 30 頁。
教你一個方法,可以把方法論專書的相關章節、加上兩三篇用了同一方法的示範論文,一起放進同一本筆記本,然後這樣問:
我要用主題分析處理 12 份半結構訪談的逐字稿。根據這些來源,請把執行步驟拆成有序的清單,每一步標註出處。如果不同來源對同一步驟的做法有分歧,請把分歧列出來,不要幫我選一個。
根據這些來源,審稿人最常質疑這個方法的哪些環節?我在論文裡應該事先交代什麼,才能擋掉這些質疑?
我猜,第二個問題是很多人沒想過的用法。方法論專書裡通常有整節在講信效度與常見批評,那正是審稿意見的預告片。
三、質性資料:讓逐字稿可以被追問
這是它在研究場景裡最被低估的用法,前提是你已經處理好前面那個資料倫理的判斷標準。
它可以直接讀音檔,也可以讀你已經整理好的逐字稿。把同一批訪談放進一本筆記本之後:
哪幾位受訪者提到了升遷制度?請逐位列出,附上他們的原話,並標註是哪一份逐字稿。
受訪者談到工作壓力時,用了哪些不同的比喻或說法?請依說法分類,每一類附上至少兩段原話。
有沒有哪一位受訪者的說法,跟其他人明顯不同?請指出不同在哪裡,並附上原話。
請注意,這三個問法都在要求原話。質性分析的編碼工作不能外包給它,因為編碼本身就是你的分析。它能做的是檢索與初步歸堆,把你從「我記得好像有人講過類似的話」那種模糊記憶裡解救出來,然後你自己回到逐字稿去做真正的詮釋。
四、寫作期:不是代筆,是體檢
寫作階段的正確用法不是叫它寫,而是叫它對照。做法是把你自己的草稿也上傳成一個來源,跟你的文獻放在同一本筆記本裡,然後:
這是我的文獻探討草稿。請逐段檢查,我提到的每一個論點是否都能在這個筆記本的其他來源裡找到對應的出處。找不到出處的段落請直接列出來。
這一個問法會抓出兩種東西:你記錯的引用,以及你以為有人講過、其實是你自己想的論點。前者要改,後者往往是你的貢獻,值得寫得更清楚。
另外一個用法,是語音摘要的批判版格式。把你的草稿單獨放一本,產生一段批判版的語音摘要,它會用對話的形式挑你的毛病。這個東西的價值不在於它挑得多準,而在於你會聽到自己的論文被別人唸出來,那個角度跟你自己讀完全不同,鬆散的段落會立刻現形。
五、口試與審稿模擬
自訂 persona 與目標的功能現在全方案都能用,而且脈絡視窗已經拉到一百萬 token(Google 官方說明)。這代表你可以把它設定成一個角色,而不是只當成問答框。
在存放你的論文全文與目標期刊近三年論文的筆記本裡,這樣設定:
請扮演這個領域的期刊審稿人。你只能根據這個筆記本裡的來源提問。請針對我的論文提出十個最可能出現在審稿意見裡的問題,依嚴重程度排序,每一題說明你為什麼問,並指出是這份稿子的哪一段引發的。
口試前兩週跑一次,你可能會發現有三、四題是自己真的答不出來的。沒關係,那三、四題就是你接下來該做的事。
歐美日韓學者怎麼用:四個可以偷的設計
我事先研究了一輪各國的機構指引、大學圖書館指南與學者的公開分享。嗯,先講一個最意外的發現:機構的官方文件幾乎一致把它定位成限定來源的讀解支援工具,而不是寫作工具,這跟多數人拿它來生成東西的用法落差很大。
以下四個設計可以直接抄。
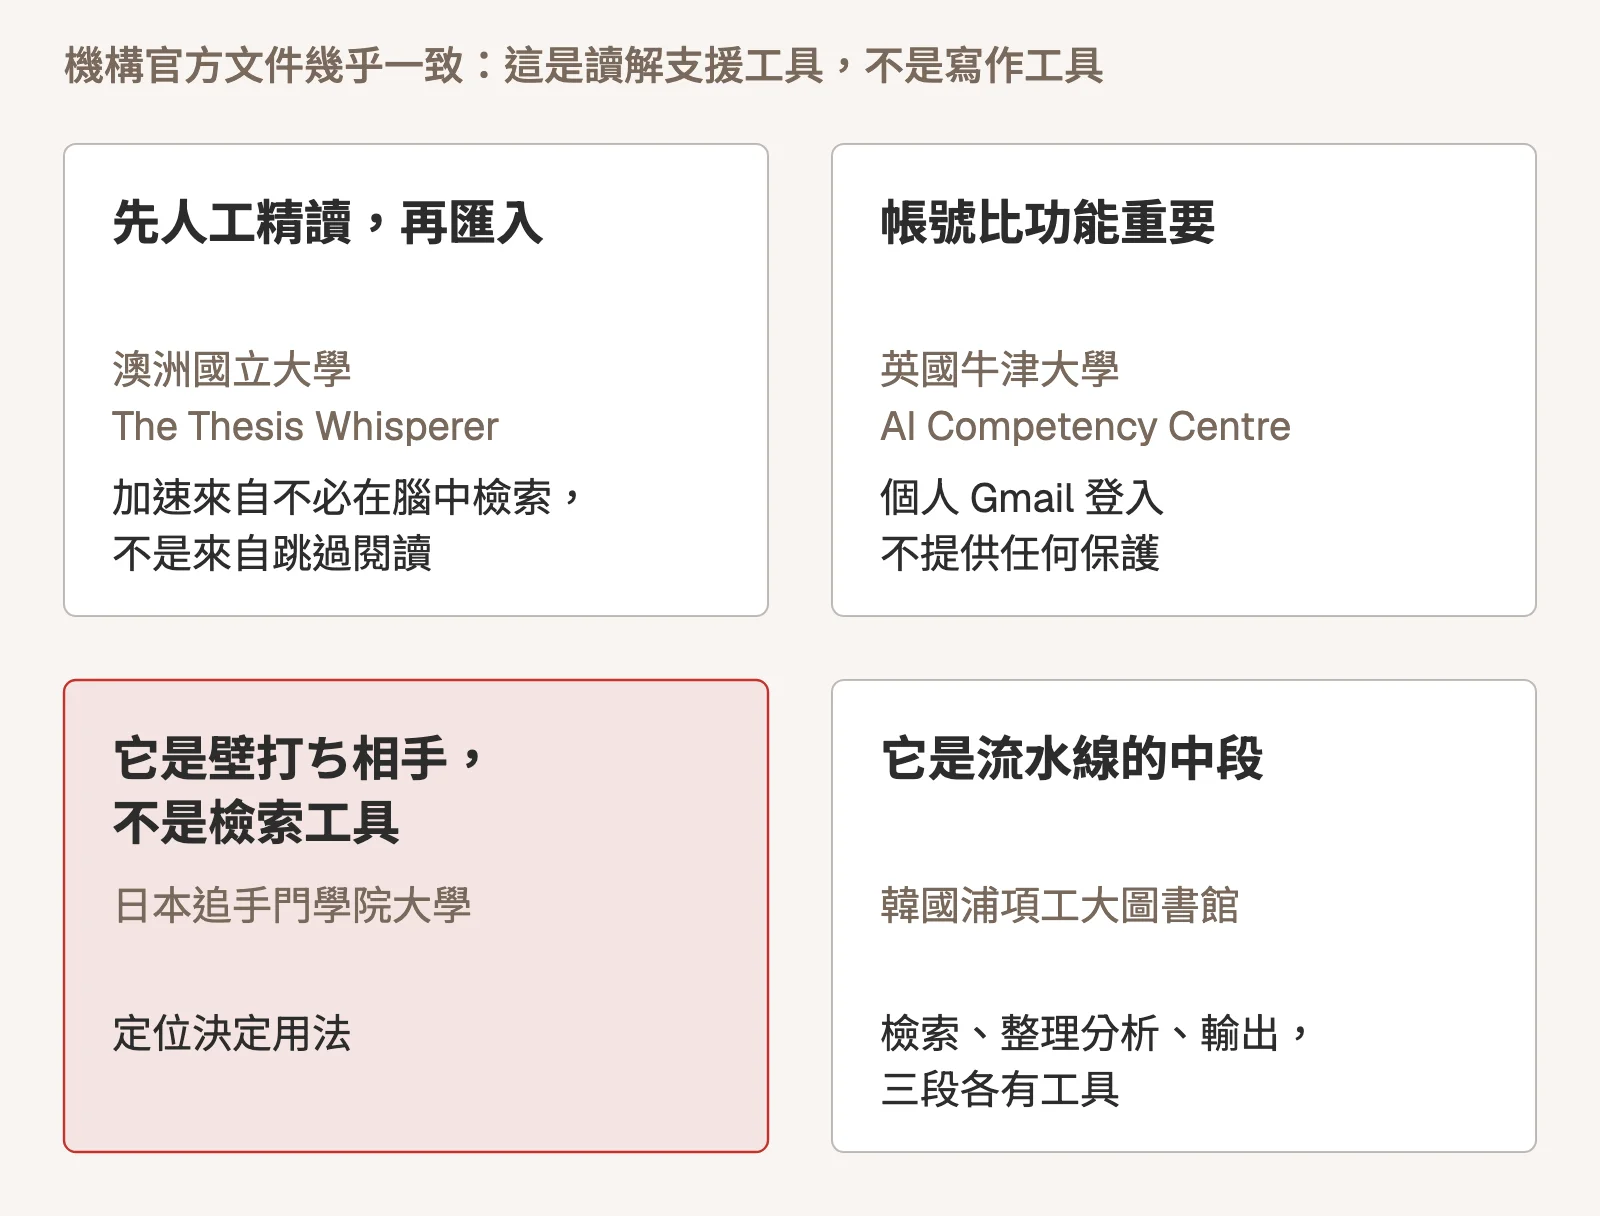
▲ 四個機構、四種定位,共同點是沒有人把它當寫作工具
設計一:先人工精讀,再匯入
澳洲國立大學的 Inger Mewburn 寫了二十年的 The Thesis Whisperer,她在 2026 年 6 月的一篇貼文裡把流程寫得很清楚:先自己精讀選出文獻再匯入,接著描述想寫的主題、問手上哪幾篇能支撐這個論點,寫完一句就回頭查是哪一篇支持,用引用標記懸停比對原文。她說文獻回顧從好幾週縮到大約半天。
關鍵在第一步。她的加速不是來自跳過閱讀,而是來自不必在腦中檢索。英國的研究者培訓講師 Catherine Pope 也給了同一條界線的另一半:她用它找回忘記出處的引文、做跨來源的主題分析,但明白拒絕讓它代寫報告,並提醒「來源裡的空白不等於學界沒人做過」(原文)。
設計二:帳號比功能重要
牛津大學在 2026 年 1 月與 Google 合作,讓全校師生透過校方的 Workspace 取得 Gemini Notebook。真正值得注意的是校方工具頁上那句警告:用個人 Gmail 登入不提供任何保護,不得用於大學的資料。
嗯,這正好對上前面那張資料分級表。牛津與哥倫比亞的指引重點都不在能不能用,而在你用哪個帳號登入。如果你的學校有機構版,今天就去換帳號,這件事的效益比你多學十個提問技巧都高。
設計三:日本人給它的定位最準確
追手門學院大學以校方帳號對全校約 9,500 名學生開放,校方指引把它定位成「壁打ち相手」,也就是練球時幫你回球的那個對手,而不是檢索工具。同一份指引要求每位教員在第一堂課宣告該門課屬於原則禁止、條件許可或積極利用三段之中的哪一段(報導)。
國立國會圖書館的《カレントアウェアネス》在 CA2079 號的〈生成AIを用いた文献調査ツール〉裡,由筑波大學的矢田竣太郎把它歸類在讀解支援,評語是雖然不是學術文獻專用工具,對論文一樣運作得不遜色,並特別提到回答內嵌可跳回原文的連結便於查證(全文)。
長崎大學醫院麻醉科的中島譽也在醫學書院《醫學界新聞》的連載裡示範得更具體:一次拖放數十份論文 PDF,要求它只依上傳的文獻作答並標示引用出處,再請它分析多篇之間的關聯(連載)。請注意那個要求只依上傳文獻作答的指令,日本的示範幾乎都會加這一句。
設計四:它是流水線的中段,不是全部
韓國浦項工大圖書館的官方生成式 AI 指南給了一條三段流程:先用圖書館的論文檢索工具蒐集文獻,再進 Gemini Notebook 整理分析,最後用簡報工具輸出。韓國釜山大學則在 2026 年 7 月公告全校師生免費取得教育版方案,授權到 2027 年 6 月。
個人的串法,更有參考價值。某位日本研究者在 Qiita 上分享過 Zotero 加 Obsidian 加 Gemini Notebook 的環境:Zotero 管書目、用外掛把 PDF 上的螢光標記轉成 Markdown 進 Obsidian,再把 PDF 與研究日誌一起丟進筆記本做跨文獻對話,產生的想法寫回 Obsidian(原文)。另一位日本使用者的做法更取巧:先用 Deep Research 只輸出純文字的 DOI 清單,貼進 Zotero 的從識別碼新增項目批次抓回書目與 PDF,全選下載後再整批上傳(原文)。
韓國一位旅居瑞士的博士研究者則把它接在通勤上:Zotero 收論文,用提示詞指定語氣轉成十分鐘的語音摘要,運動時聽完再回去讀原文,最後回 Zotero 生成註解筆記接上寫作(原文)。另一位韓國使用者的細節,也值得偷學:刻意不合併上傳,五篇論文各自建一份語音摘要與一張心智圖,通勤時挑著聽(原文)。這跟我前面講的節省額度是相反的取捨,因為那種用法要的是一篇一篇認人,不是橫向比較。你要哪一種,取決於你在哪個階段。
然後是那些不太好看的數字
對了,我們前面講過它的錯誤率不是零。既然各國學者都在用,那就看看實測數字到底長什麼樣。
美國西北大學與明尼蘇達大學的研究團隊用 300 份文件做語料測試,Gemini Notebook 的幻覺率是 13%,同期的 Gemini 2.5 Pro 與 ChatGPT 各為 40%。這個對比很漂亮,但同一份研究還有兩個發現比較不漂亮:它一旦出錯,平均每則答案含三個幻覺;而且三者都出現詮釋越界,把原文裡有歸屬的意見寫成定論(arXiv:2509.25498)。最後那一點對研究者特別危險,因為「某某學者認為」跟「研究顯示」在論文裡是兩種完全不同的句子。
另一份系統性回顧的資料抽取實測,涵蓋 57 篇文獻、1,710 格資料,格層級正確率 91.17%,重大事實錯誤只有 4 格,人時從推估的 165 小時降到 17.7 小時。但作者點名主要限制是抽取不完整,錯誤以遺漏為大宗(全文)。它的錯多半不是亂講,而是漏講,而漏講比亂講難發現得多。
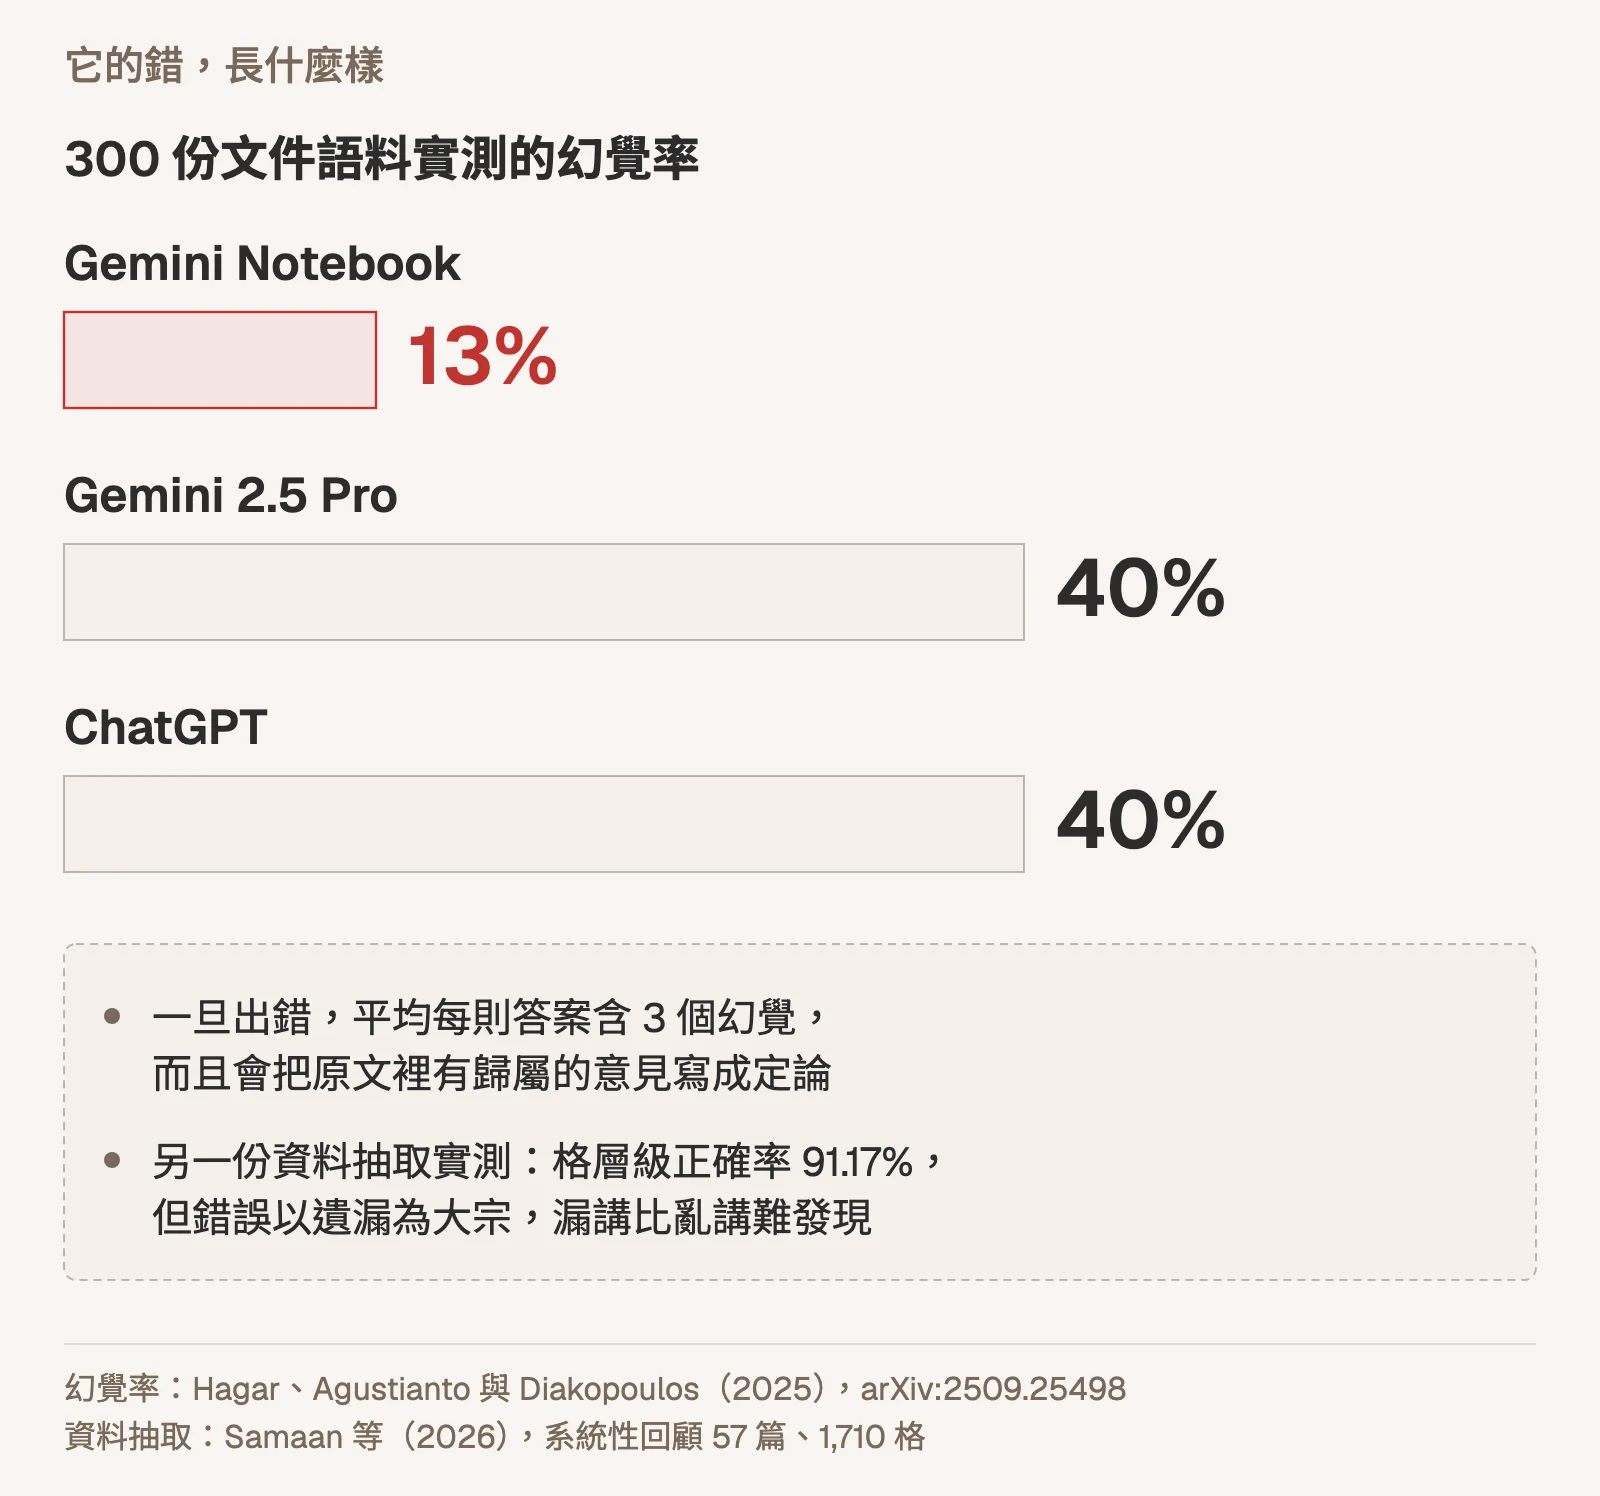
▲ 13% 比 40% 好看,但它的錯是漏講而不是亂講,這才是難防的地方
美國匹茲堡大學的 Ian Flynn 與 Sean Peters 在美國地球物理聯盟的刊物上報告了一個更具體的現象:他們拿三篇火星火山學論文產生語音摘要,每一份都有錯,而且錯誤都落在結尾,其中一次從某個火山地形直接外推出火星有液態水與生命,原文完全沒有這個說法(報導)。實務結論很簡單:語音摘要愈到後面愈不可信,那通常是它在收尾時自己補的。匈牙利 ELTE 的 poltextLAB 用六篇立法研究文獻測試,也抓到引註誤植與頁碼不符,結論是不能當成成品(測試報告)。
也有從根本反對的聲音。美國新澤西州羅文大學(Rowan University)的 Tiffany DeRewal 副教授批評這類工具會弄錯、會編造,而且錯得複雜又不明顯,對新手研究者的認知發展有實質傷害(訪談)。這個批評值得認真聽一下,特別是如果你正在寫第一本學位論文。分辨的辦法很簡單,就是問自己一個問題:這件事我是本來就做得到、只是做得慢,還是我從來沒學會?前者可以交給它,後者交出去的是你的訓練。
至於長期的方向,ESCP 商學院與加拿大渥太華大學、英國倫敦大學貝葉斯商學院的研究者分析了 1980 年代以來一千四百多篇文獻回顧之後主張,AI 可以接手蒐集、分類與摘要這些描述性工作,研究者的角色會從查證來源,移到決定什麼重要、這個領域該往哪裡走(研究簡介)。這句話拿來當這一節的收尾正好:你省下來的時間,要花在判斷上,而不是花在多讀三十篇文獻上。
用 AI Agent 與 vibe coding 補上它的三個缺口
前面說過它做不到四件事,其中三件可以靠外掛補。這一節讓我來講講具體怎麼補,以及哪些做法有風險。
嗯,先把定位講清楚:Gemini Notebook 是終點站,不是全線。它擅長的是在一批已經被挑選過的材料裡做深度工作,而挑選材料、把材料整理成它讀得下去的形狀、把結論搬出來變成你的檔案,這三段它都不做。這三段正好是 AI Agent 與寫幾行程式最擅長的事。
缺口一:它不會替你找文獻,前段交給 agent
它的 Discover sources 是網路搜尋,不是學術檢索。正確的分工是:檢索與驗證在前段用 agent 做,篩完的 PDF 才進筆記本。
我自己的前段是 Zotero 加上 MCP。Zotero 管書目與畫線,Claude Code 透過 MCP 直接讀我的文獻庫,用完整的中文句子問「我庫裡有哪些文獻在處理這個爭議」,篩出來的那一批才丟進 Gemini Notebook 做橫向比較。裝法我寫在《讓 AI 直接讀你的文獻庫:Zotero MCP 從安裝到上手的完整教學》。
這樣分工,還有一個附帶好處:進筆記本的每一篇都是你自己收過、看過摘要的文獻,來源的品質由你把關,而不是讓模型去網路上撈。
缺口二:它不能自動化,而官方 API 只開給企業
這一點的現況跟網路上流傳的說法不同,值得講清楚。
Google Cloud 確實有官方 API,可以建立筆記本、管理來源、產生語音摘要,但那是 Gemini Notebook Enterprise 的端點,狀態還是 Pre-GA Preview,適用預覽版條款、支援有限,而且需要 Gemini Enterprise 授權(Google Cloud 文件)。你在 notebook.google.com 用的那個消費者版,沒有可以自助申請金鑰的公開 API。
社群因此做了幾套逆向工程的方案,其中 tmc/nlm 是命令列工具兼 MCP 伺服器,roomi-fields/notebooklm-mcp 則持續在維護並已適配改名後的新網址。另一套一度很多人用的 PleasePrompto 版本,已經在 2026 年 9 月 10 日封存不再維護。
已經有人把整條線都接起來了。WenyuChiou/research-hub 是 Zotero 加 Obsidian 加 Gemini Notebook 的三件套,固定迴圈是搜尋、驗證論文是否真的存在、補齊書目欄位、寫回 Zotero、生成 Obsidian 筆記、打包上傳、產簡報,驗證失敗的論文會被隔離並記錄退件理由。NZBridge 則是從 Zotero 那一端接:外掛開一個本機伺服器,批次把 PDF 推進筆記本、依 Zotero 的分類自動命名,再把筆記拉回 Zotero 掛上標籤。另有 notebooklm-py 直接把自己定位成給 Claude Code 這類 agent 用的合成層,由 agent 負責編排流程。
用不用,我的建議是這樣:
這些工具呼叫的是未公開的內部端點,多數專案的說明檔自己就寫明屬於未授權的自動化存取。我查不到可信來源證實使用這類工具本身會導致帳號被停權,但這句話的意思是查無證據,不是保證安全。改名那次就曾讓依賴舊網址的工具集體失效,這種事還會再發生。
所以,實務上的界線是:拿它做重複性高、失敗也無所謂的雜事(例如把一個資料夾裡的 PDF 批次建成筆記本),不要把它放進你交稿前一天非跑不可的流程裡,也不要用你的主力 Google 帳號去賭。真正重要的研究資料,走手動上傳那條路,慢不了多少。
缺口三:東西出不來,就用 vibe coding 自己接
筆記本無法完整匯出,也沒有官方的 Zotero 匯出。這個缺口最務實的補法不是找外掛,而是自己寫二十行程式。
所謂 vibe coding 在研究場景裡的正確定位是:寫一次性的小工具處理你自己的資料,不是寫產品。沒有其他使用者、不需太多的維護、甚至用完就丟,所以不需要你會寫很複雜的程式,只需要你講得清楚要什麼。我常用的有三種。
第一種是前處理。免費版一本筆記本只有 50 個來源,但單一來源可以吃 50 萬字,所以把三十篇 PDF 合併成一份帶有清楚分隔標記的 Markdown 再上傳,額度會省非常多,而且引用時它仍然標得出是哪一篇。這件事叫 Claude Code 做,一句話的事。掃描檔的文字辨識也一起在這一步做掉,不要讓沒有文字層的 PDF 混進去。
第二種是後處理。你在筆記本裡問出來的那張文獻矩陣,複製出來之後讓它轉成 CSV 或 Markdown 表格,存進你自己的專案資料夾。這一步的意義是把結論落地成你可以版控、可以搜尋的檔案,而不是留在一個你隨時可能被改版影響的雲端服務裡。
第三種是對帳。這一種最值得做:把它給你的引用清單,跟你的 Zotero 文獻庫對一次,看有沒有哪一筆你的庫裡根本沒有。這條驗證在防的是什麼,我在《論文腳註裡的 Gemini 分享連結:查文獻不能偷懶照抄 AI》裡寫過那個真實案例。
這三種加起來,是一條可以重複跑的流水線:agent 負責找與驗證、Claude Code 負責整形、Gemini Notebook 負責理解與比較、再由幾行程式把結論搬回你的硬碟。工具會改版、會改名、甚至會收掉,但這條流水線的形狀不會變。這種「先有流程、再挑工具」的思路,我在《別只學 AI 工具:研究者如何打造一個可重複運作的學術副駕駛》談得更完整。
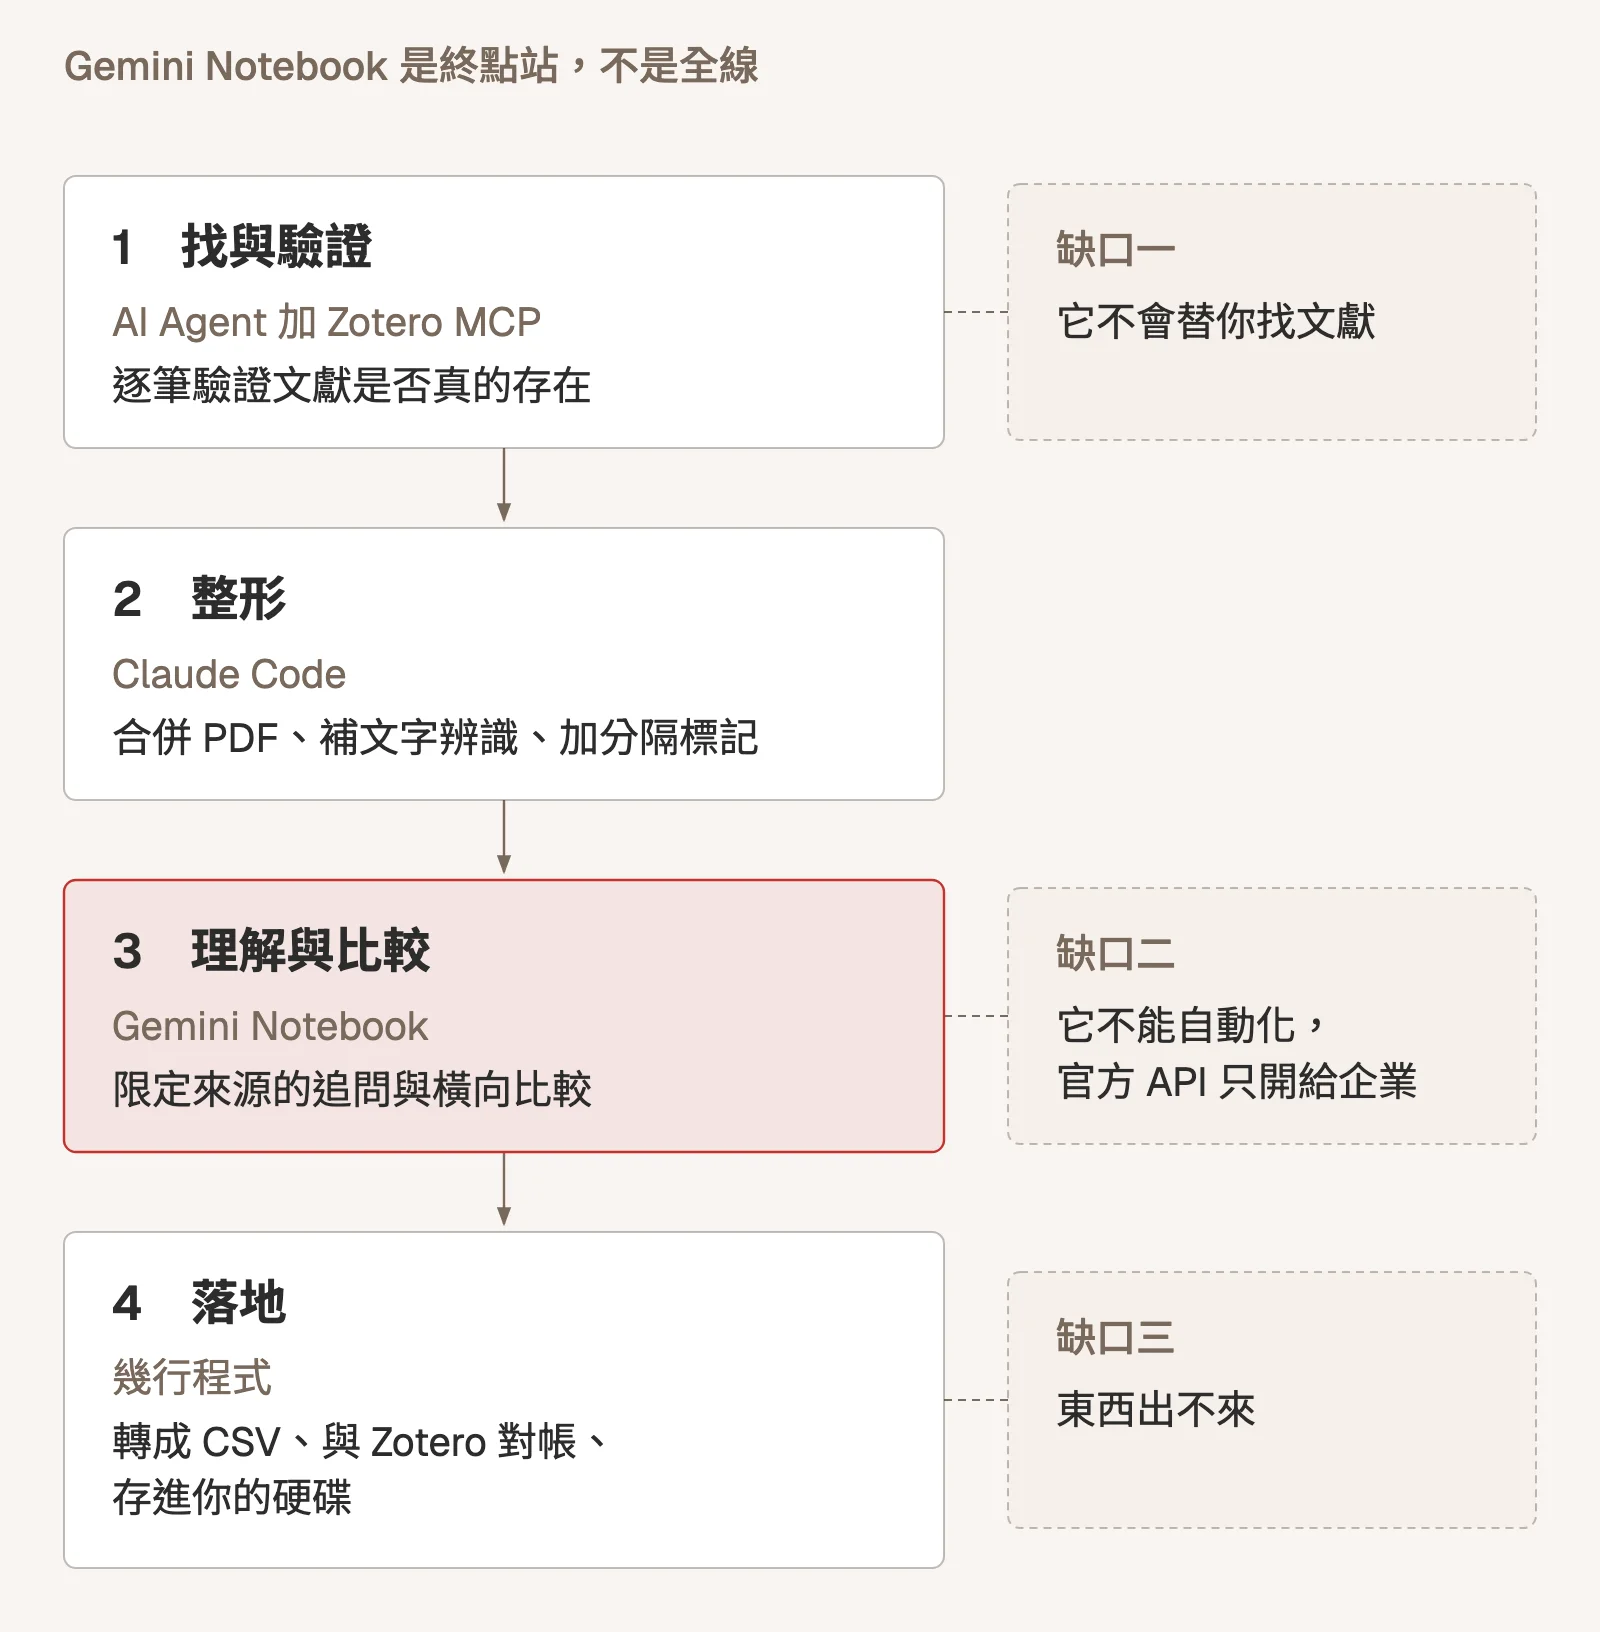
▲ 三個缺口都在它的上下游,補法也都在上下游
一個值得知道的進階設計
日本北陸先端科學技術大學院大學與大阪公立大、神奈川大、東北大的研究者在 2026 年 8 月公開了一個很不一樣的玩法:他們不做提示詞工程,而是把一套含十六個學術參數的論文本體論餵進去當成型別系統,讓它對你的研究構想做型別檢查,指出哪些欄位還沒填、哪些地方前後不一致,回傳的是反思問題而不是答案(arXiv:2608.05545)。作者自己也說量化效果尚未驗證,所以這不是可以照抄的做法。
我把它寫進來,是因為它示範了一種思路:你餵進去的不一定是要讀的材料,也可以是檢查你自己的框架。把你們領域的投稿須知、一份寫得很好的研究設計檢核表、三篇口試委員寫過的審查意見放進同一本筆記本,再把自己的研究計畫丟進去對照,得到的東西會比問它「幫我看看這個研究計畫如何」有用十倍。
五個一定會踩到的雷
一、免費版的提問額度比你想的少。每天 50 次,跑一張完整的文獻矩陣加上追問,一個上午就用完了。實務做法是先把問題寫在文字檔裡想清楚,再一次貼進去,不要用聊天的節奏亂問。
二、掃描檔會無預警失敗。沒有文字層的 PDF 它讀不到任何一個字,但可能不會顯示錯誤,只會給你一段看起來合理的空話。上傳前先試著在 PDF 裡選取文字。
三、來源愈多,答案愈平均。這是機制問題不是你問得不好。超過二十篇就分成核心層與外圍層兩本,不要貪心。
四、語言支援不是全功能一致。語音摘要的輸出語言超過八十種,但長度控制與插話互動目前只支援英語;影片摘要的電影風格也僅限英語(官方說明)。另外有臺灣使用者實測反映,生成的簡報在繁體中文筆畫較多的字會出現模糊,這一點我沒有找到官方或學術層級的評測,寫在這裡只當作使用前的心理準備。
五、它會改版,而你的結論要落在自己的硬碟裡。一年之內它改了名、換了網址、換過模型引擎,社群工具跟著壞過一輪。任何你打算寫進論文的東西,當天就複製出來存成檔案。
三條倫理線
AI 摘要不等於你讀過。引用之前,關鍵段落自己看過原文。它的引用定位在實測裡有九成五的正確率,聽起來很高,但換個方向想,那代表每二十筆就有一筆會把你帶到錯的地方。出錯的時候掛的是你的名字。
研究判斷不外包。理論對話對象的選擇、研究缺口的認定、質性資料的編碼,這三件事是研究工作的本體。它可以幫你把材料攤開,攤開之後的判斷是你的貢獻,也是口試委員真正要問的東西。
該揭露就揭露,而且先確認你要交給誰。目前查不到有哪家期刊或大學針對這個工具訂了專屬條文,都是比照一般生成式 AI 的規範處理。麻煩的是這些規範的強度差距極大,而差距落在哪裡,決定你要不要留提示詞。
Elsevier 的規定是:AI 不得列為作者,用於寫作時須在正文末、參考文獻之前設一段生成式 AI 使用聲明,載明工具名稱、用途與人為監督程度,並會隨論文刊出;純粹的文法拼字檢查免揭露(官方政策)。比利時魯汶大學則逐階段規定得更細:文獻檢索可以用但必須逐條查證,產生含新想法的文字、程式碼、合成資料或視覺化都須揭露,只當文法助手免揭露,並明文禁止用 AI 做計畫書與稿件的學術評審(研究誠信辦公室)。
日本則是三種強度並存。情報處理學會全國大會的立場是不禁止使用、責任全歸作者、未強制揭露;日本教育工學會要求涉及核心內容時明示工具與目的;醫學書院 2026 年 2 月的第二版最嚴,要求揭露工具名稱、版本與製造商、具體使用方式、所用的提示詞,以及用在論文的哪個部分,違反可退稿或撤稿(投稿規範)。韓國研究財團則發布了《大學研究者生成式 AI 研究倫理指南》,分研究設計、執行、報告三階段規範並附自檢表。
實務上的意思,其實是:如果你有可能投稿到要求交提示詞的期刊,就從第一天開始把提示詞存下來,不要等被要求時才回想。至於該怎麼寫揭露聲明,我之前曾開發過一個免費小工具,說明在《用了 AI 不可恥,藏起來才有風險》可以找到。
一週上手清單
如果你讀到這裡覺得該試試,那實在太好了!因為,這就是最短的路徑。
第一天,請先去查查你有沒有學生方案資格,把帳號準備好;如果要放未發表的資料,請用學校的帳號登入。
第二天,只做一件事:建一本理論對話對象的筆記本,放進你最熟悉的八篇文獻,跑一次文獻矩陣那個問法,然後逐格回去核對原文。這一天的目的不是產出,是校準你對它錯誤率的直覺。
第三天到第四天,建立方法論的筆記本,問那兩個問題,把答案整理成你自己論文第三章的骨架。
第五天,把你已經寫好的任何一段草稿丟進去做出處檢查,看它抓出幾個你記錯的引用。
第六天,試一次批判版的語音摘要,聽著你的草稿被挑毛病。提醒一下,這也許會令你不太舒服,但有其必要。
第七天,決定哪幾本筆記本要留下來長期使用,請把其他的刪掉。工具的價值不在於你開了幾本筆記本,而在於你回頭用到了哪幾本。
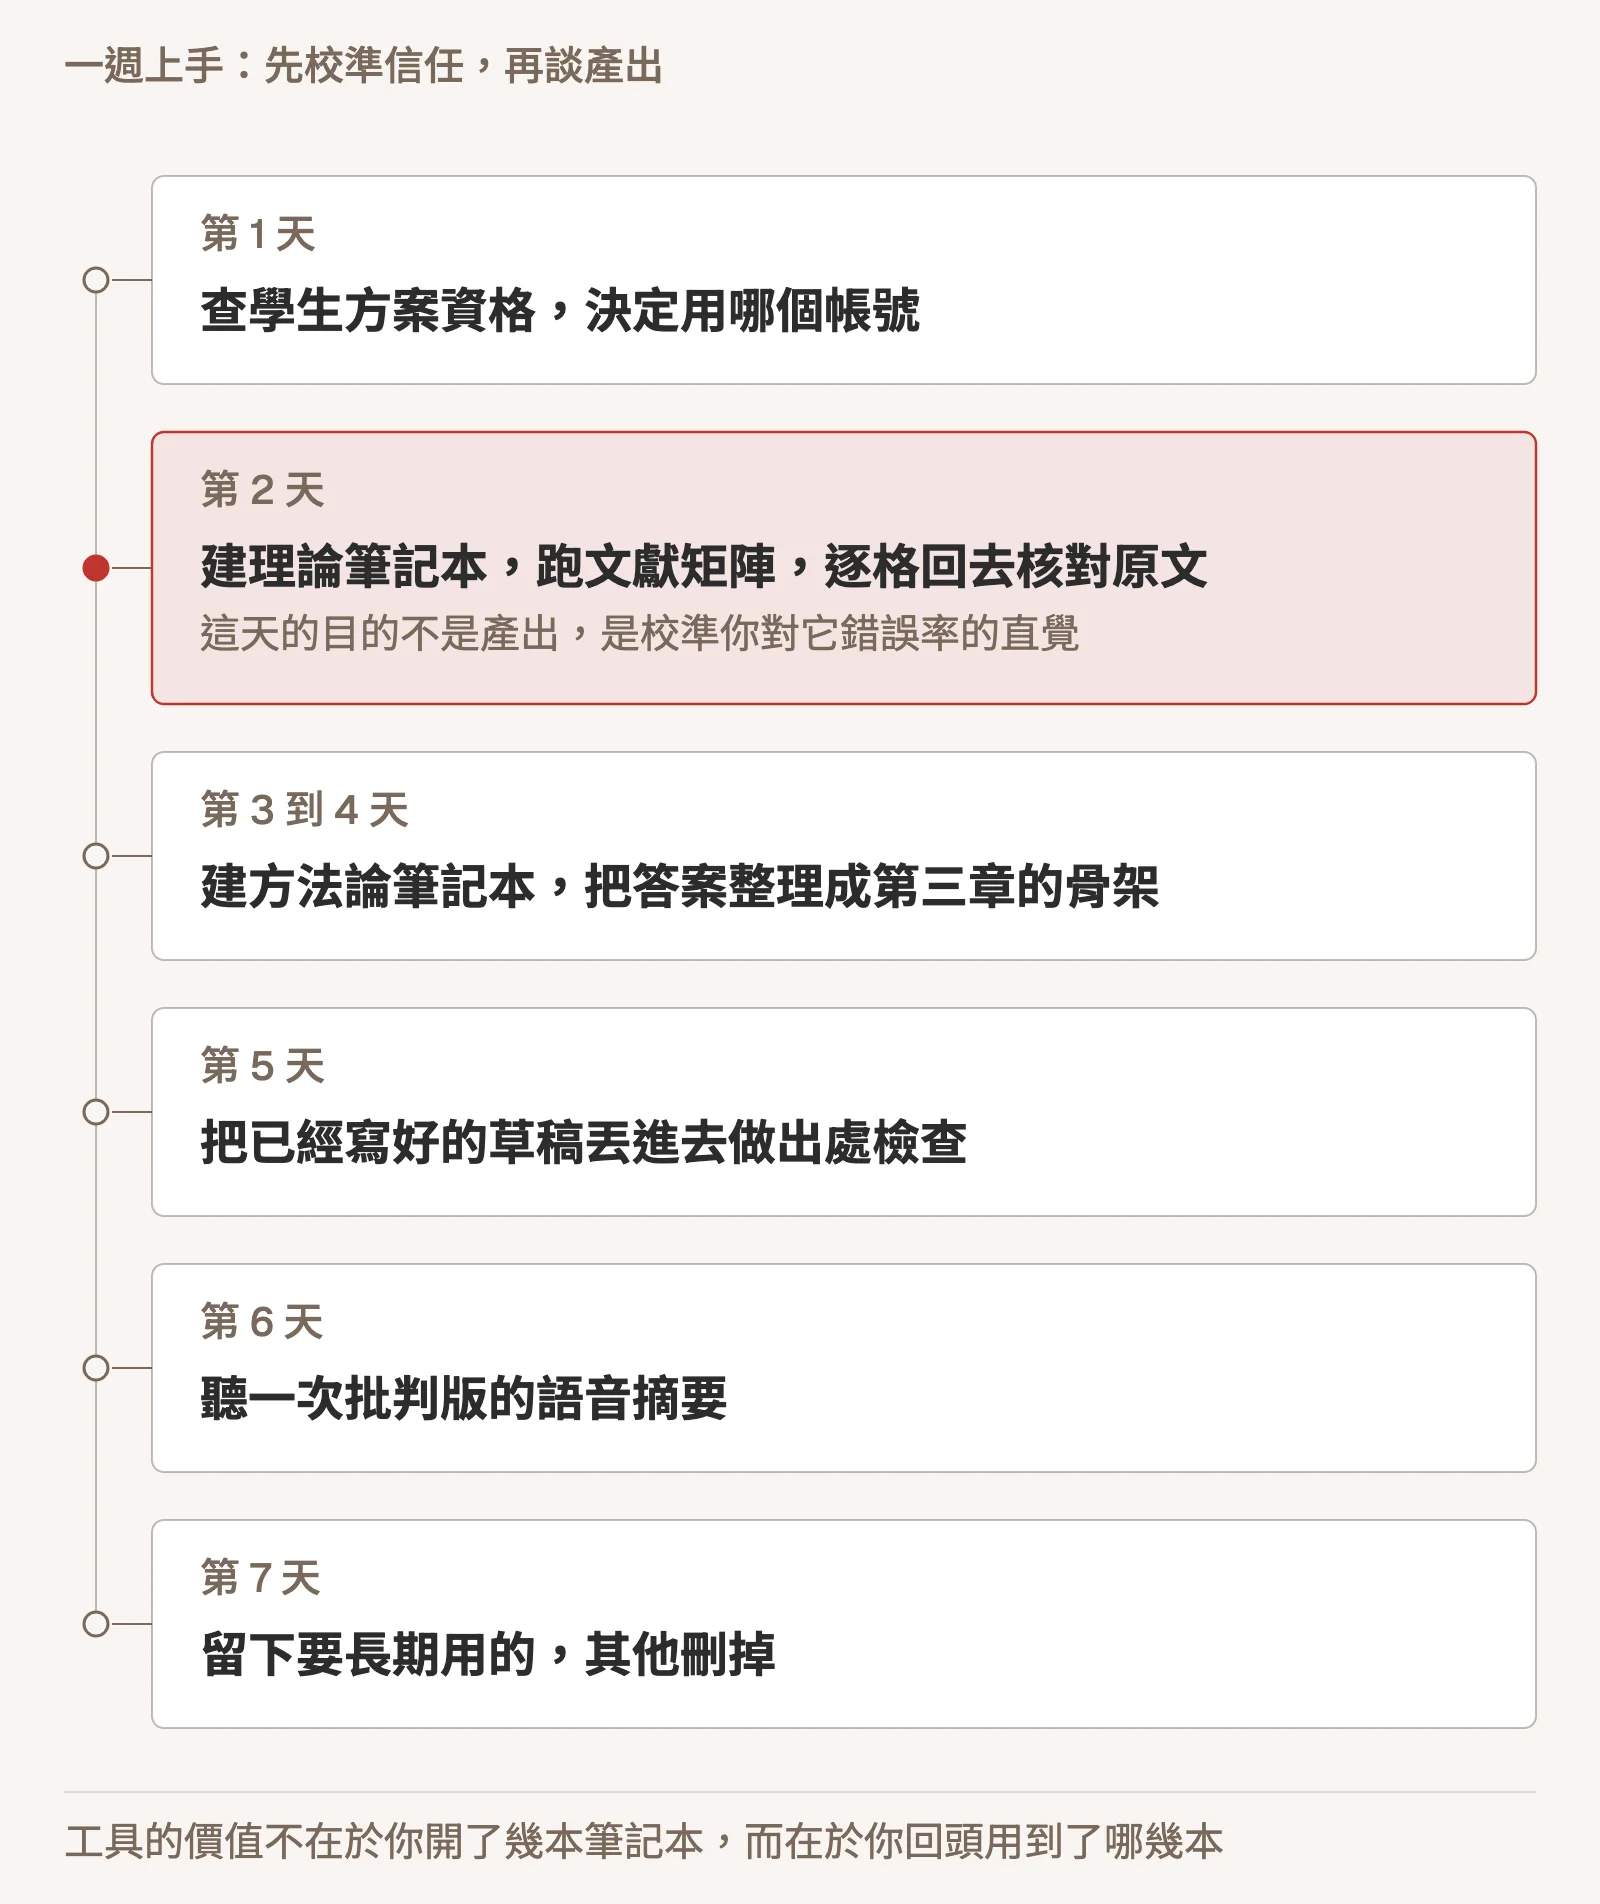
▲ 七天裡最重要的是第二天:那天你不是在產出,是在決定要信它多少
不要覺得這樣做有點麻煩,有的時候最短的捷徑就是繞遠路,而繞遠路很可能才是最短的捷徑。
我得說,善用 Gemini Notebook 並不會讓你立刻變成更好的研究者,但它可以放大你的視野與既有的研究習慣。但凡文獻收錄得用心、問題想得清楚的人,用它從事研究會快很多;反觀那些材料本來就凌亂、問題本來就模糊的人,只會更快地得到一堆看似四平八穩的廢話。請謹記:AI 是一個放大器,不是萬靈丹。關於這件事,我在〈一把可以開很多扇門的鑰匙:我在凱旋醫院講的 AI 心法〉講過同一個道理,只是換了個場合。
如果你想更有系統地把 AI 帶進研究流程:從文獻搜尋與驗證,一路到閱讀、寫作與投稿,歡迎參加我的《AI 賦能學術研究與寫作實戰工作坊》,用半天時間把 AI 變成你的研究副駕駛;還沒準備好報名的話,先從免費課程開始。
常見問題
訪談逐字稿或還沒發表的論文,可以上傳到 Gemini Notebook 嗎?
要看你用哪個帳號,以及那份資料受什麼約束。Google 的說明是筆記本內容不會被直接用來訓練基礎模型,除非你按下回饋按鈕,那會連同來源檔案一起送出並由人員審閱、保留最長三年;而 Workspace 與教育版帳號即使給了回饋也不會被人工審閱或用於訓練。所以未發表的稿件建議用學校的機構帳號並避免按回饋,至於受訪者逐字稿,請先回去看你的研究倫理同意書有沒有寫明可以上傳到第三方雲端服務,沒寫就不要上傳。
免費版夠用嗎?什麼時候該付費?
免費版是每本筆記本 50 個來源、最多 100 本、每天 50 次提問、每天 3 則語音摘要。做一張完整的文獻矩陣再追問幾輪,一個上午就會用完那 50 次提問。付費前先做兩件事:一是查學生方案,Google 在 2026 年 9 月宣布美國以外 140 多個市場提供大學生免費一年的方案,兌換期限是 2026 年 12 月 31 日;二是改變問法,把問題先在文字檔裡想清楚再一次貼進去,額度的消耗會差很多。
它標了引用來源,是不是就不會亂講?
不是。來源標註提高的是可追溯性,不是正確性。實測數字兩面都有:有研究測得它的幻覺率約 13%,明顯低於同期的通用模型,但同一份研究發現它一旦出錯,平均每則答案含三個幻覺,而且會把原文裡有歸屬的意見寫成定論。另一份系統性回顧的資料抽取測試則顯示,它的錯誤以遺漏為大宗而非捏造,而遺漏比捏造更難被發現。凡是要寫進論文的內容,關鍵段落都要自己回到原文看過。
用它整理文獻,投稿時需要揭露嗎?
目前沒有期刊針對這個工具訂專屬條文,都是比照一般生成式 AI 規範,而各家強度差很多。Elsevier 要求用於寫作時在參考文獻前設一段聲明,載明工具名稱、用途與人為監督程度;魯汶大學要求文獻檢索可用但須逐條查證,產生新想法的內容須揭露;日本醫學書院的規範最嚴,連使用的提示詞與用在論文哪個部分都要交代。實務建議是從第一天就把提示詞存下來,並依你的目標期刊規定撰寫聲明。
已經在用 ChatGPT 或 Claude 的專案功能,還需要多學這一套嗎?
兩者解決的問題不同。ChatGPT 與 Claude 的專案是通用對話加上你的檔案,模型仍可能引入來源以外的知識;Gemini Notebook 的設計是把答案限制在你上傳的來源裡並附可跳回原文的引用,比較適合需要交代出處的研究工作。另一方面它有一些對手目前沒有的產出形式,例如四種格式的語音摘要、影片摘要與心智圖。比較務實的分工是:檢索與驗證交給 AI Agent,限定來源的理解與比較交給 Gemini Notebook,通用寫作與程式交給你原本慣用的模型。


