目錄11 節
▲ 論文會被交出去,但真正留下來的是寫論文的那個人。
澳洲國立大學(The Australian National University, ANU)的 Inger Mewburn 教授,擔任該校的研究人員發展主任(Director of Researcher Development,亦稱研究培訓主任 Director of Research Training),負責為全校的研究生與研究人員規劃、監督專業發展與培訓計畫。
她同時也是知名學術部落格 The Thesis Whisperer 的創辦人與主編,專門在網路上為全球的博士生提供學術職涯與論文寫作的建議。她寫了十幾年,是英語世界研究生最常讀的博士生存指南之一。2026 年 6 月,她寫了一篇文章,標題是〈The ‘P’ in PhD does not stand for ‘prompt’〉(博士的 P 不是 prompt)。
這句話聽起來有點好笑,但卻容易刺傷人,是因為它出自一個重度 AI 使用者之口。
在同一篇文章裡,Mewburn 教授坦白交代自己的用法:她用 Gemini Notebook 處理文獻回顧,把原本要花好幾週的工作壓縮到半天,估計每週至少省下十二個小時。她不是站在對立面喊話的人。
真正讓她寫下那句話的,源自於一位新生的坦白。那位學生說自己用 AI 讀論文、用 AI 生摘要,理由是「我不太喜歡讀論文」。Mewburn 教授在文章裡回了一句話,大意是:我不喜歡寫學術論文,老實說也不特別喜歡讀,可是,那不就是這份工作本身嗎?
她還用了一個很重的比喻:最近她覺得自己像個發乾淨針頭給毒品使用者的人,卻只能眼睜睜看著他們在面前使用過量。
這篇文章要處理的,不是誠信問題
在研究者基地網站上已經有一篇〈研究生該怎麼用 AI 才不踩線〉,處理的是誠信與揭露:哪些做法會違規、期刊怎麼規定、被抓到會怎樣。那條線很重要,但那是外部的線,由制度來畫。
這篇文章要談的是另一條線,而且是更難的那一條:就算沒有任何人發現,就算你完全合規,你還是可能虧了。
因為對研究生來說,大家在研究所階段真正要產出的東西,從來不只是那本論文。真正要培育的,是一個能提出好問題、能判斷證據強弱、能為每一個研究選擇辯護的人。而那個被寄予厚望的研究生,只能靠你自己一次一次卡住、一次一次想通,才能順利長成。
讀完這篇文章,你可以拿到三樣東西:一個判斷哪些能外包、哪些不能的判斷標準,歐美日韓等國的學術界已經把話說到哪裡的全貌,以及七條今天就能開始執行的行動綱領。
想先看圖解?這篇文章另有一份 100 頁的教學簡報版〈博士的 P 不是 prompt:研究生的判斷力保衛戰〉,以淡網格與紅筆批註為母題:網格是機器排好的秩序,紅筆是人做的判斷。三個判準做成流程圖,土耳其實驗、歐美日韓的政策時間軸與七條行動綱領也都畫成圖表,適合自學或課堂投影搭配閱讀。
教授可以、學生不行,這是雙重標準嗎
先處理這個最容易讓人反彈的問題。Mewburn 教授自己每週用 AI 省十二小時,卻要學生老實讀論文,聽起來很像那種「我當年是怎麼苦過來的」的長輩發言。
但仔細看,它不是。差別在一個地方:她已經有能力判斷,AI 給她的東西是好是壞?
當 Gemini Notebook 把三十篇文獻整理成一份摘要,Mewburn 掃過去的那幾分鐘裡,她的腦袋同時在做好幾件事:這個學派的立場被簡化得太扁了;這裡漏掉了 2019 年那場重要的爭論;這句話聽起來很順,但它其實把相關講成了因果。她能在幾秒內抓到這些,是因為她已經在這個領域讀了二十年。
AI 對她而言是放大鏡,因為她手上本來就有東西可以放大。
對一個還沒讀過那三十篇文獻的研究生來說,同一份摘要遞過來,他沒有任何可以比對的底稿。他看到的是一份完整、通順、看起來很有道理的東西,而他唯一能做的判斷是「嗯,好像滿合理的」。
韓國高麗大學校長金東元在 2023 年發布該校 AI 指引時,講過一句很精準的話:ChatGPT 產不出超越使用者自身實力的成果。
這句話有兩層意思。第一層大家都懂:AI 不會讓你變強。第二層比較少人提:它的輸出品質上限,其實卡在你的鑑別力上。你只能認出你已經懂的東西。你看不出來的錯,就會原封不動進到你的論文裡。
所以那不是雙重標準,而是同一個標準在不同能力階段的不同結果。Mewburn 教授用 AI 加速的是她已經會的事,但卻有些研究生用 AI 跳過的是他還不會的事。
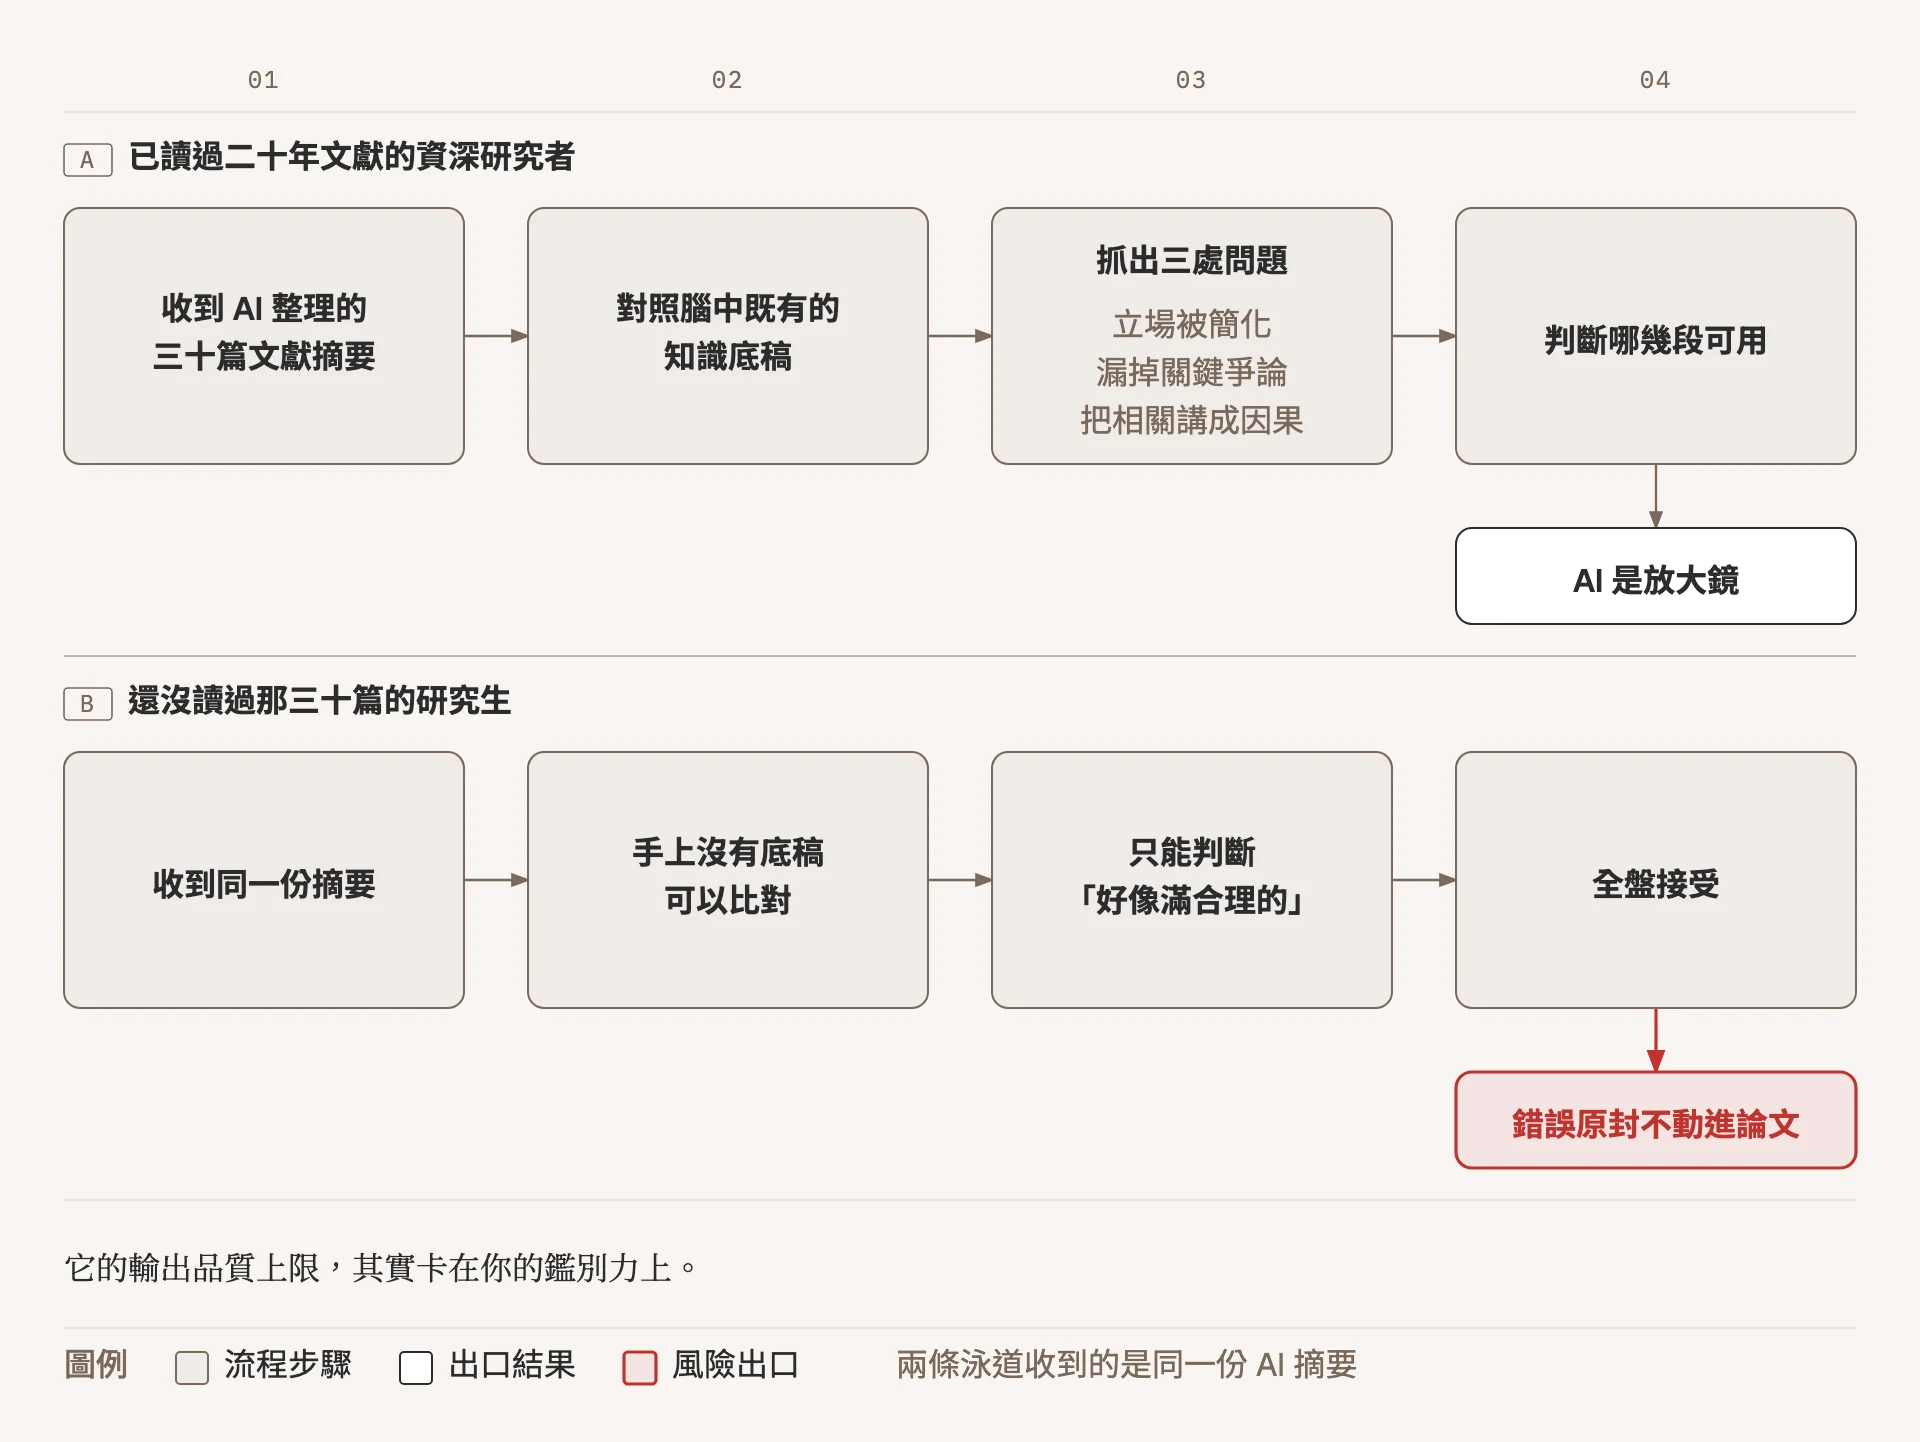
▲ 同一個工具,落在不同的能力基礎上,結果完全不同。
被外包掉的不是時間,是你正在長的那塊肌肉
前面講的是直覺上的道理,接下來讓我們來看看證據。這幾年累積的實證研究,指向一個一致但違反直覺的結論。
當下表現好,不代表你學會了
認知心理學家 Robert Bjork 與 Elizabeth Bjork 提出過一個概念,叫「有益的困境」(desirable difficulty)。核心主張是:某些讓你當下覺得吃力、進度變慢的學習條件,反而會帶來更好的長期保留與遷移。
他們的原話是這樣的:當下的表現不是學習的可靠指標,學習只能靠延遲之後的提取來衡量。
這句話值得研究生深思。因為 AI 最擅長改善的,正是當下的表現。你今天的進度條走得更快了,但那條進度條量的是產出,不是學習。
Bjork 夫婦還指出一個很常見的陷阱:反覆閱讀會產生熟悉感,而熟悉感會讓人誤以為自己懂了,他們稱之為「理解的錯覺」。讀 AI 生成的摘要,製造的正是這種錯覺,而且效率比反覆閱讀高得多。
相關的學習科學證據還有兩條。一是 1978 年就被確立的「生成效應」(Generation Effect):自己生成出來的材料,記得比被動讀到的牢。二是 Roediger 與 Karpicke 的提取練習研究:即時測驗時,重複閱讀組表現較好,但延後兩天或一週之後,做過測驗的那組留存量顯著高出許多,儘管重複閱讀組當下對自己的記憶更有信心。
這三條合起來,描述的是同一件事:困難本身在做工。而 AI 最主要的價值主張,就是替你移除困難。
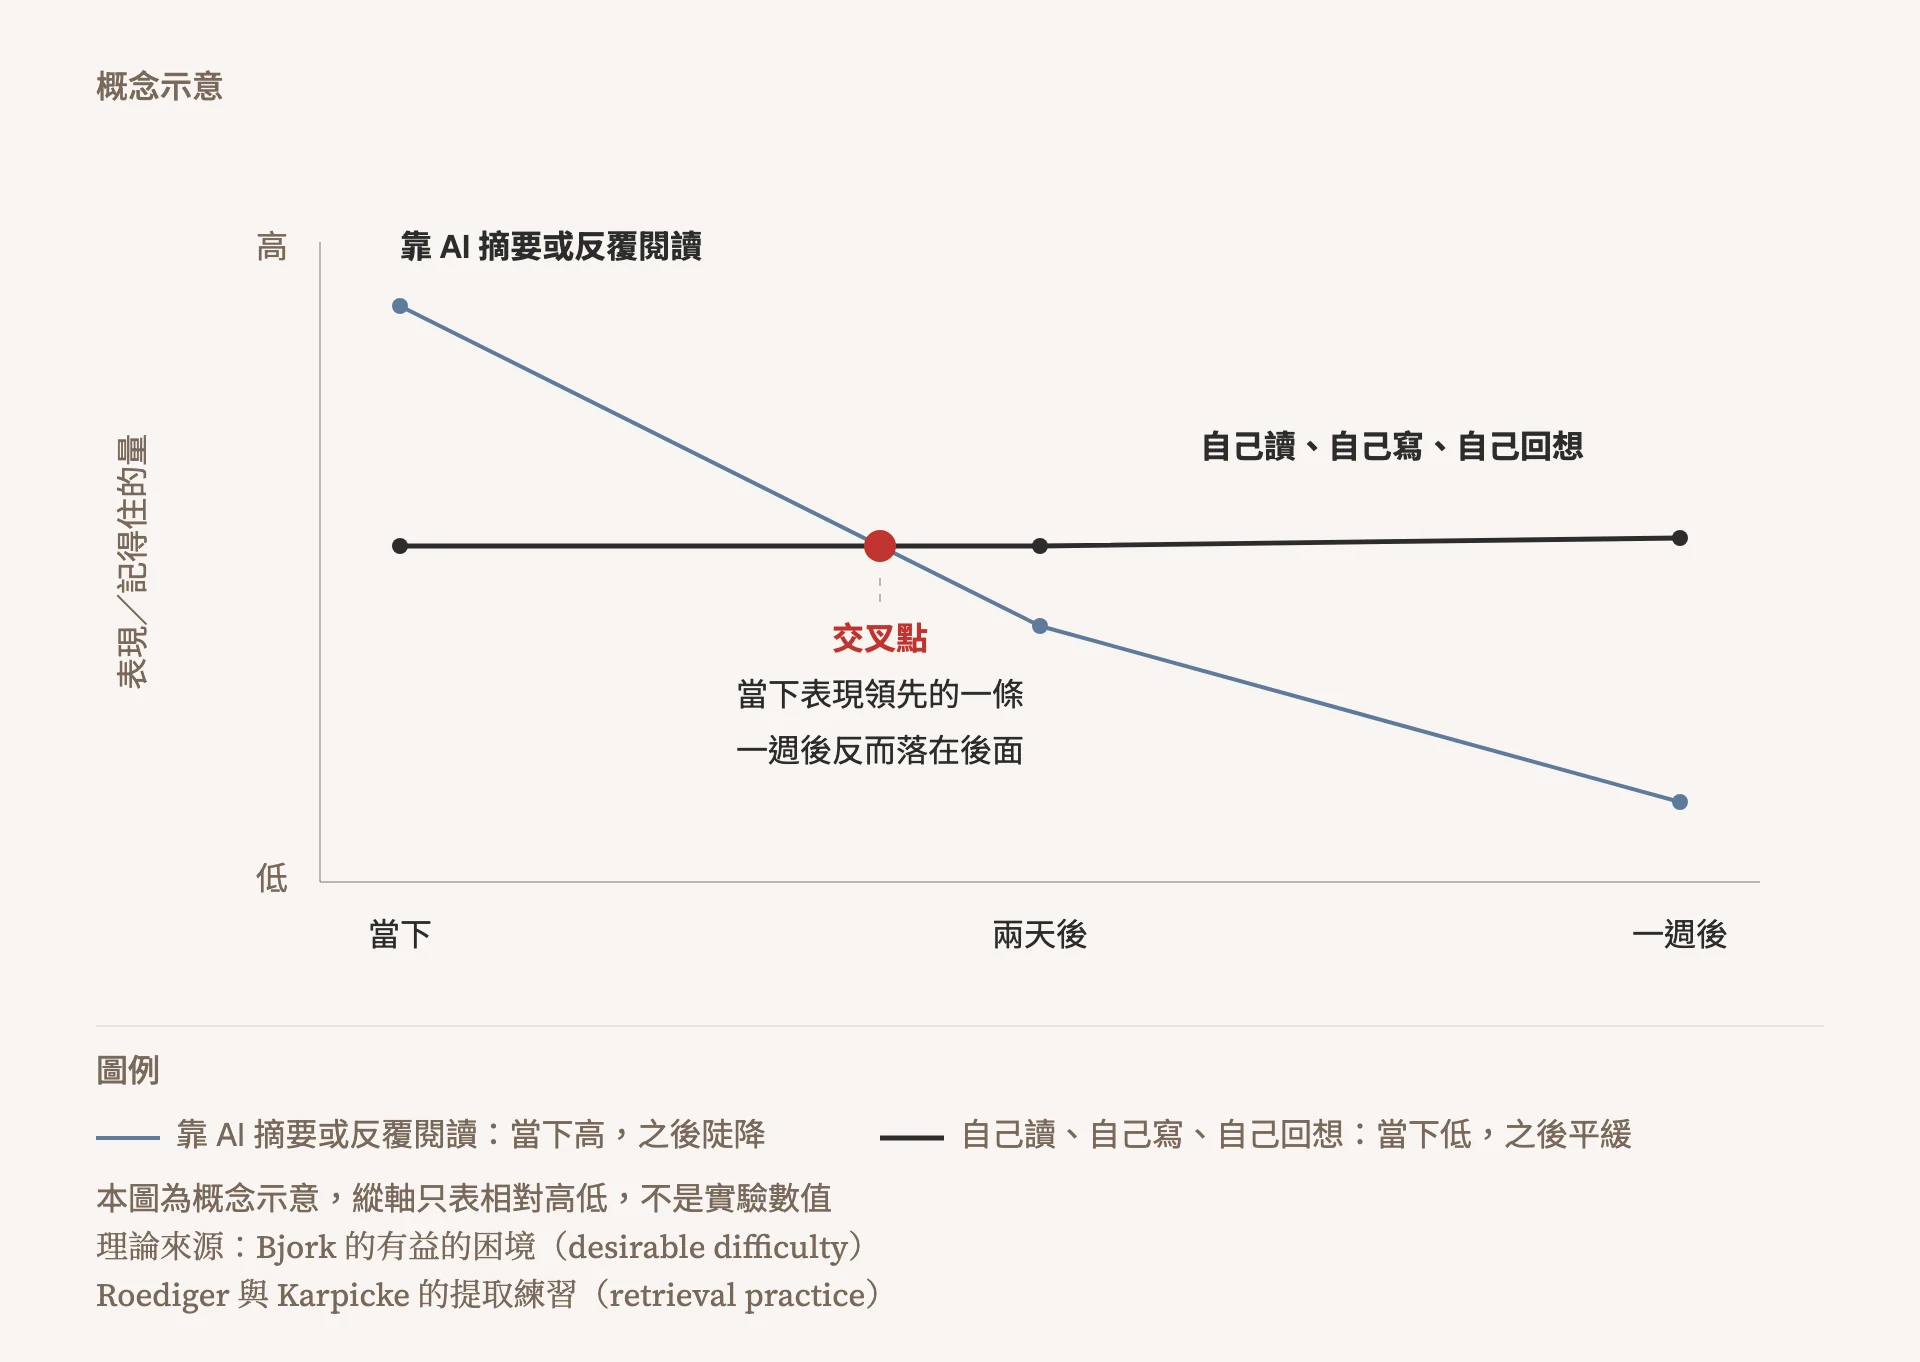
▲ 當下的表現不是學習的可靠指標,真正的差距要延遲之後才看得出來。
拐杖拿掉之後會發生什麼
真正把這件事量化出來的,是一項發表在 PNAS 的田野實驗。
研究團隊在土耳其的高中找了將近一千名學生,隨機分成三組做數學練習。一組沒有 AI,一組使用模仿標準 ChatGPT 介面的版本(研究者稱為 GPT Base),一組使用加了學習防護欄的版本(GPT Tutor,設計成給引導提示而不直接給答案)。
結果分兩段看。
第一段,在有 AI 可用的時候:GPT Base 組的表現提升 48%,GPT Tutor 組提升 127%。看起來 AI 是明確的助力。
第二段,把 AI 拿掉之後考試:GPT Base 組的成績比從未接觸過 AI 的對照組還要低 17%。
研究者在論文裡用了一個很直白的字:這些學生把 GPT-4 當成了練習時的拐杖。拐杖在的時候走得更快,拐杖拿掉之後,腿比原來還弱。
而 GPT Tutor 那一組的防護欄,大幅消除了這個負面效果。這是全篇最重要的一個對照,我們稍後會回來談它。
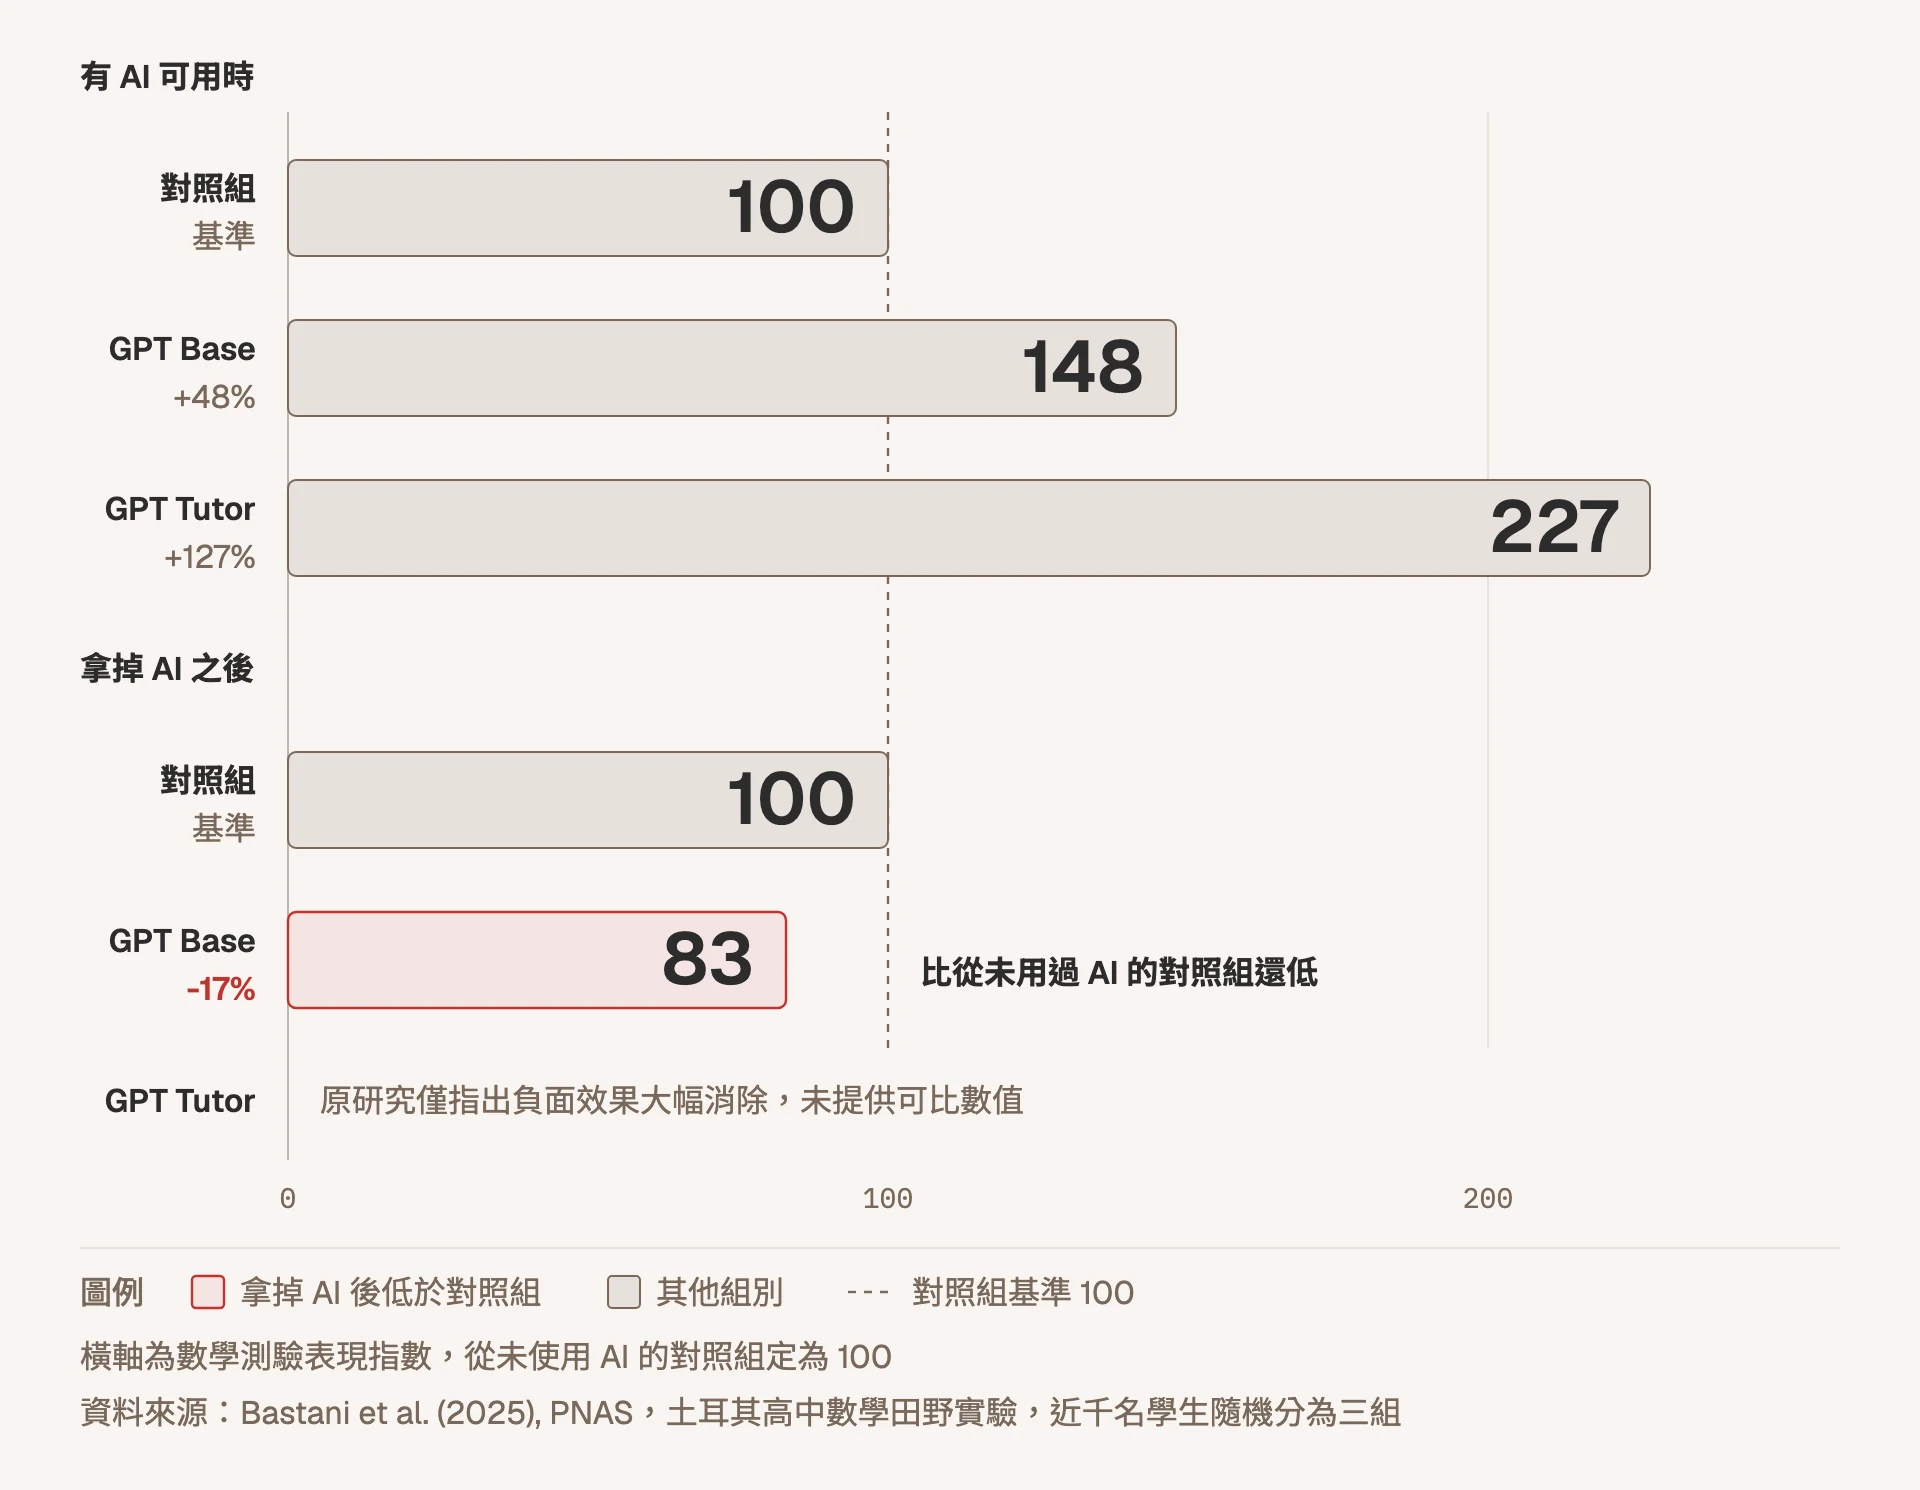
▲ 差別不在用不用 AI,而在你讓它替你做了哪一段。
腦波、批判思考與自動化的弔詭
再補三條證據,但每一條都要註明它的限制,因為這三條在網路上被過度引用的程度都相當嚴重。
第一條,美國 MIT 媒體實驗室的〈Your Brain on ChatGPT〉。54 名受試者分成大型語言模型組、搜尋引擎組與純腦組,做寫作任務並量測腦波。結果顯示純腦組的腦區連結最強最分散,語言模型組最弱;語言模型組對自己文章的所有權感最低,甚至難以正確引述自己剛寫完的句子,研究者稱之為「認知負債」。
必須說清楚的是:這是 arXiv 預印本,未經同儕審查,樣本只有 54 人,而且最關鍵的第四階段只有 18 人完成。作者自己在專屬網站上呼籲勿過度解讀。它是一條值得注意的線索,不是定論。
第二條,Michael Gerlich 的認知卸載研究。666 名受試者的問卷與訪談,發現頻繁使用 AI 工具與批判思考能力呈顯著負相關,中介變項是認知卸載增加,年輕族群的依賴度更高。但這是橫斷面的相關研究,不能推論因果,而且該文在 2025 年 9 月發布過一則表格錯誤的正式更正。引用時兩件事都要講。
第三條,Microsoft Research 與卡內基美隆大學的知識工作者調查。319 名受試者、936 則第一手使用實例。這篇的發現比前兩條更細膩,也更有用:對 AI 的信心愈高,批判思考愈少;但對自己任務能力的信心愈高,批判思考愈多。
這篇論文轉述了一句 1983 年就被提出的觀察,叫做自動化的反諷(Ironies of Automation),我認為它是整個議題最好的一句註解:
你把例行工作機械化、只把例外交給人處理,等於剝奪了使用者日常練習判斷、鍛鍊認知肌肉的機會,等例外真的發生時,他們早已萎縮且毫無準備。
話說回來,研究所就是那個專門生產例外的地方。你的論文之所以值得寫,正因為它問的是還沒有標準答案的問題。如果你用 AI 把所有例行的部分都處理掉,等真正的例外站到你面前時,你會發現自己從來沒有練習過。
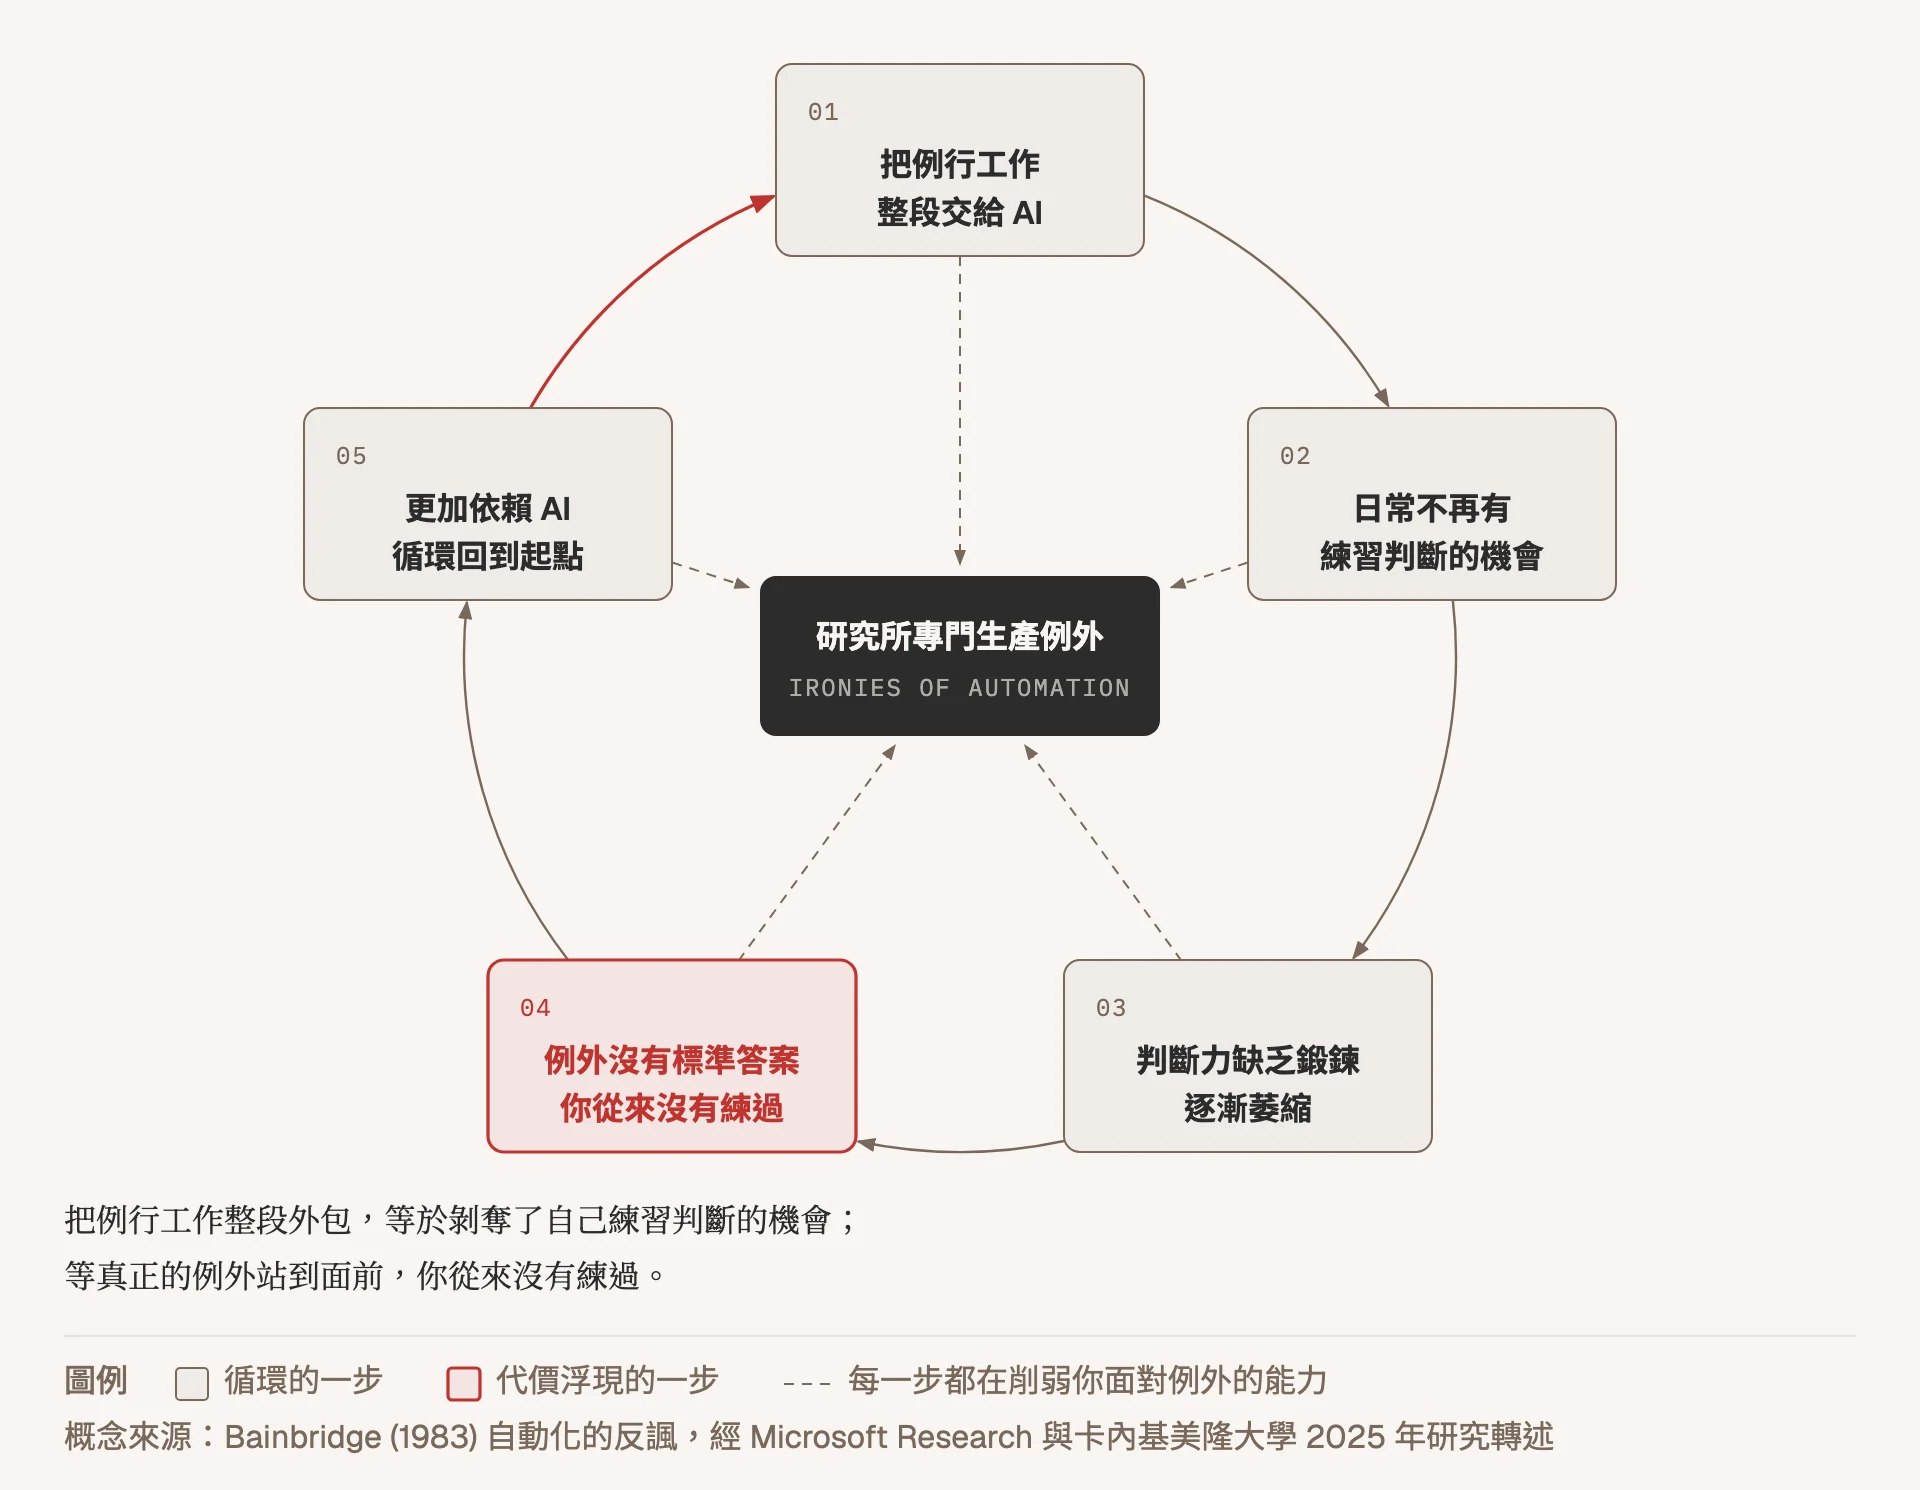
▲ 自動化的反諷:省掉的每一次例行判斷,都是你沒有練到的那一次。
但本文的用意不是要你別用
如果文章寫到這裡就收尾,那它只是一篇包裝得比較精緻的恐嚇文。證據的另一半同樣有力,而且不能略過。
AI 對專業工作的增益,是真實且可觀的。美國哈佛商學院與波士頓顧問公司合作的隨機田野實驗找了 758 名顧問,結果是:在能力範圍內的任務上,使用 GPT-4 的顧問平均多完成 12.2% 的任務、速度快 25.1%、品質高出 40% 以上。而且原本表現低於平均的人進步 43%,高於平均的人進步 17%,差距是被拉近的。另一項發表於 Science 的實驗找了 453 名專業工作者,平均耗時減少 40%,產出品質提升 18%。
但同一個 BCG 實驗,還測試了另一件事。研究者刻意設計了一項落在 AI 能力邊界之外的任務,結果使用 AI 的顧問答對率比完全不用 AI 的人低 19 個百分點。研究者把這個現象稱為「鋸齒狀的技術邊界」(Jagged Technological Frontier):AI 的能力邊界不是一條平滑的線,而是忽高忽低的鋸齒,而且從外面看不出來邊界在哪裡。
嗯,這正是研究生的處境。你的題目很可能就坐落在那個鋸齒的凹陷處,而你沒有經驗判斷自己掉在哪一邊?
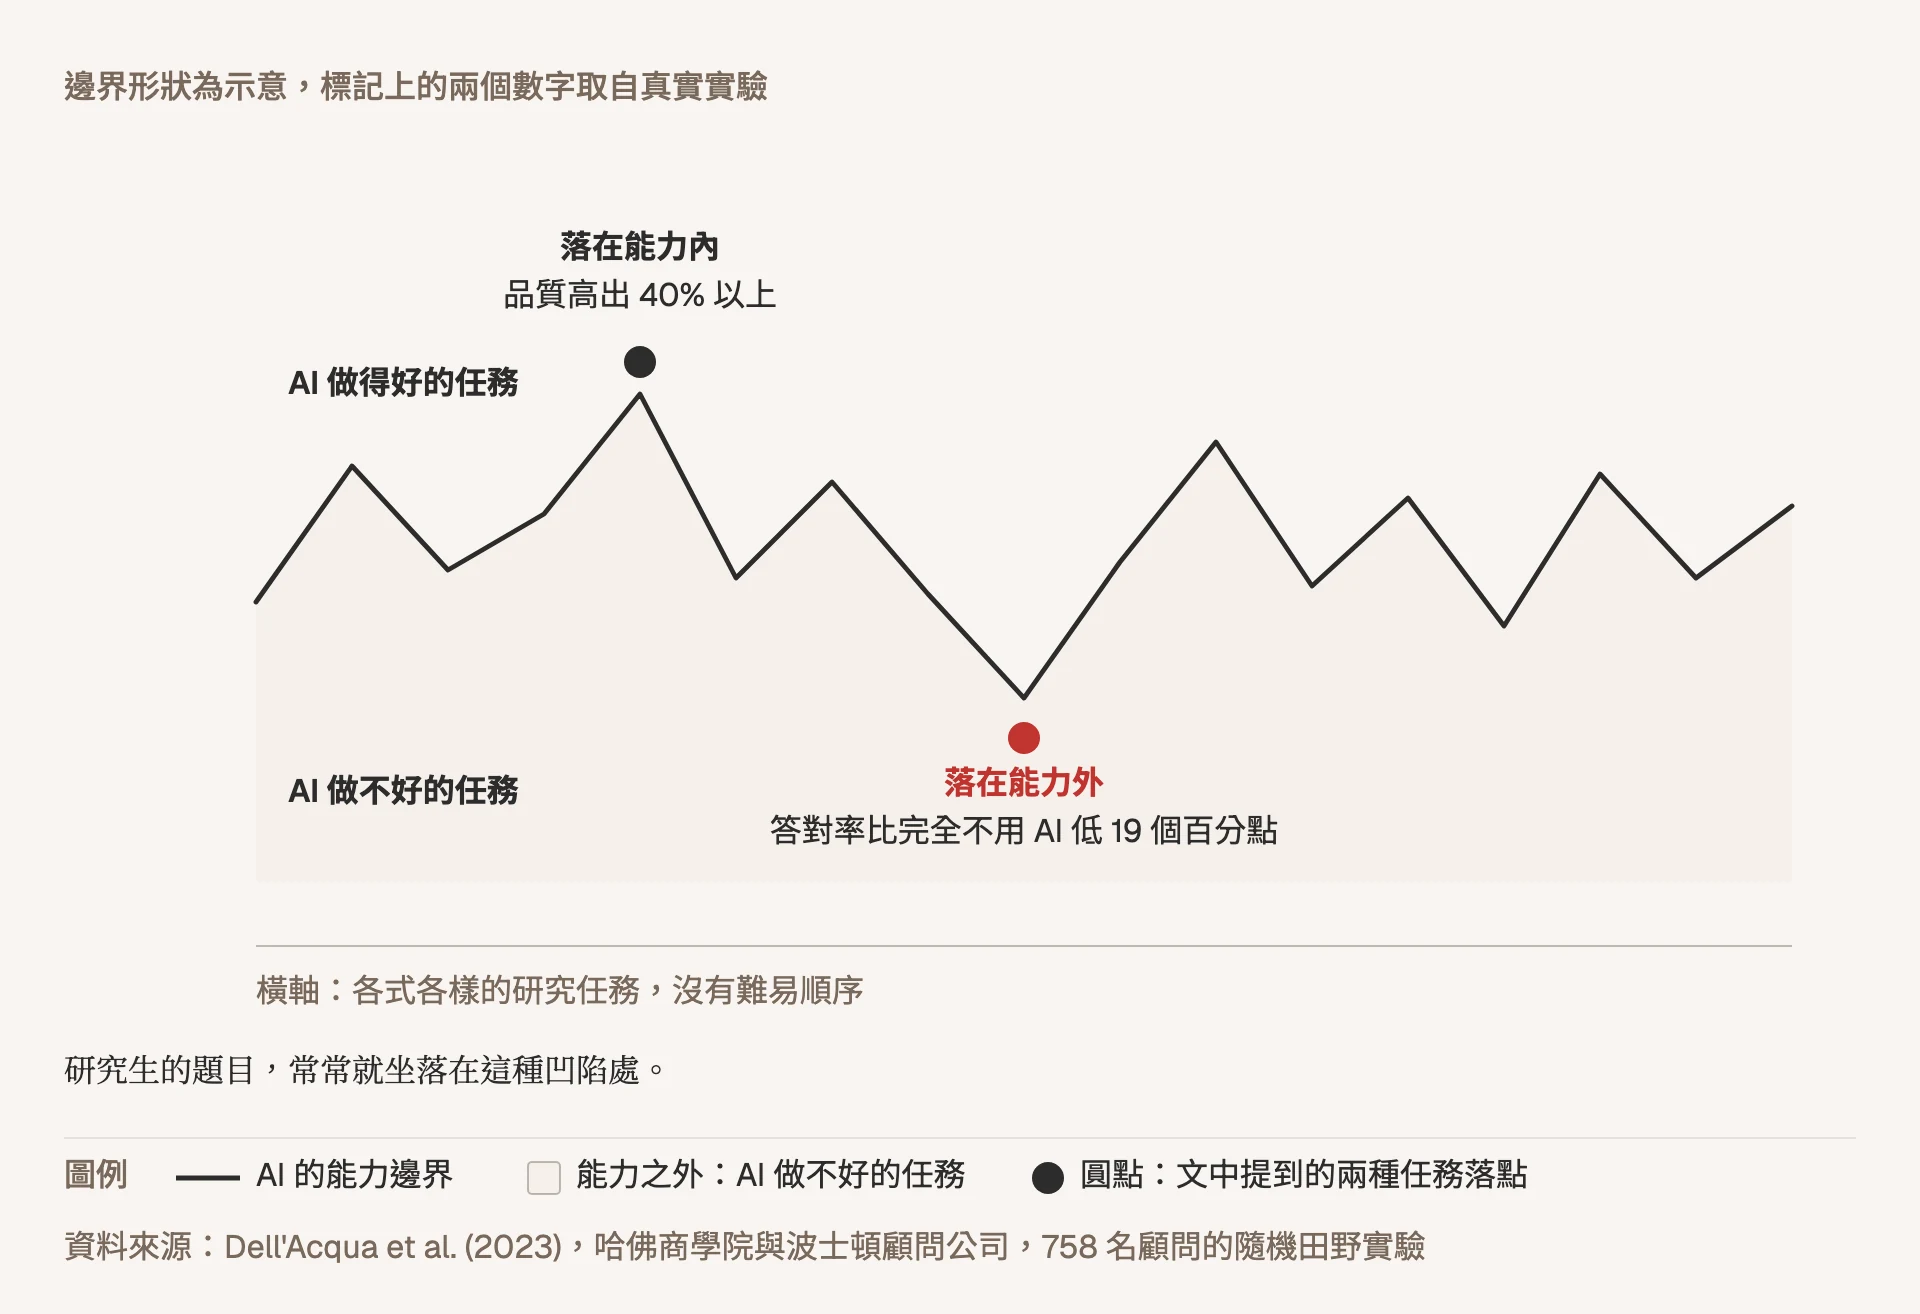
▲ 邊界的形狀從外面看不出來,你的題目落在哪一邊也一樣。
決定結果的是設計,不是用量
回到土耳其的那個實驗。同樣是 GPT-4,同樣是那群學生,一組學習被損害,一組學習被增強。差別只在於:一個直接給答案,一個只給引導。
還有一篇研究把這個機制講得更清楚。2026 年發表的一項調查訪問了 522 名研究生,發現三種 AI 使用行為都正向預測研究能力,但關鍵在於:這條路徑是經由批判思考中介的。
換句話說,批判思考不是 AI 的受害者,而是 AI 能不能替你產生價值的必要通道。你保留愈多自己判斷的環節,AI 帶給你的增益愈大;你把判斷整段交出去,增益就在通道口消失了。
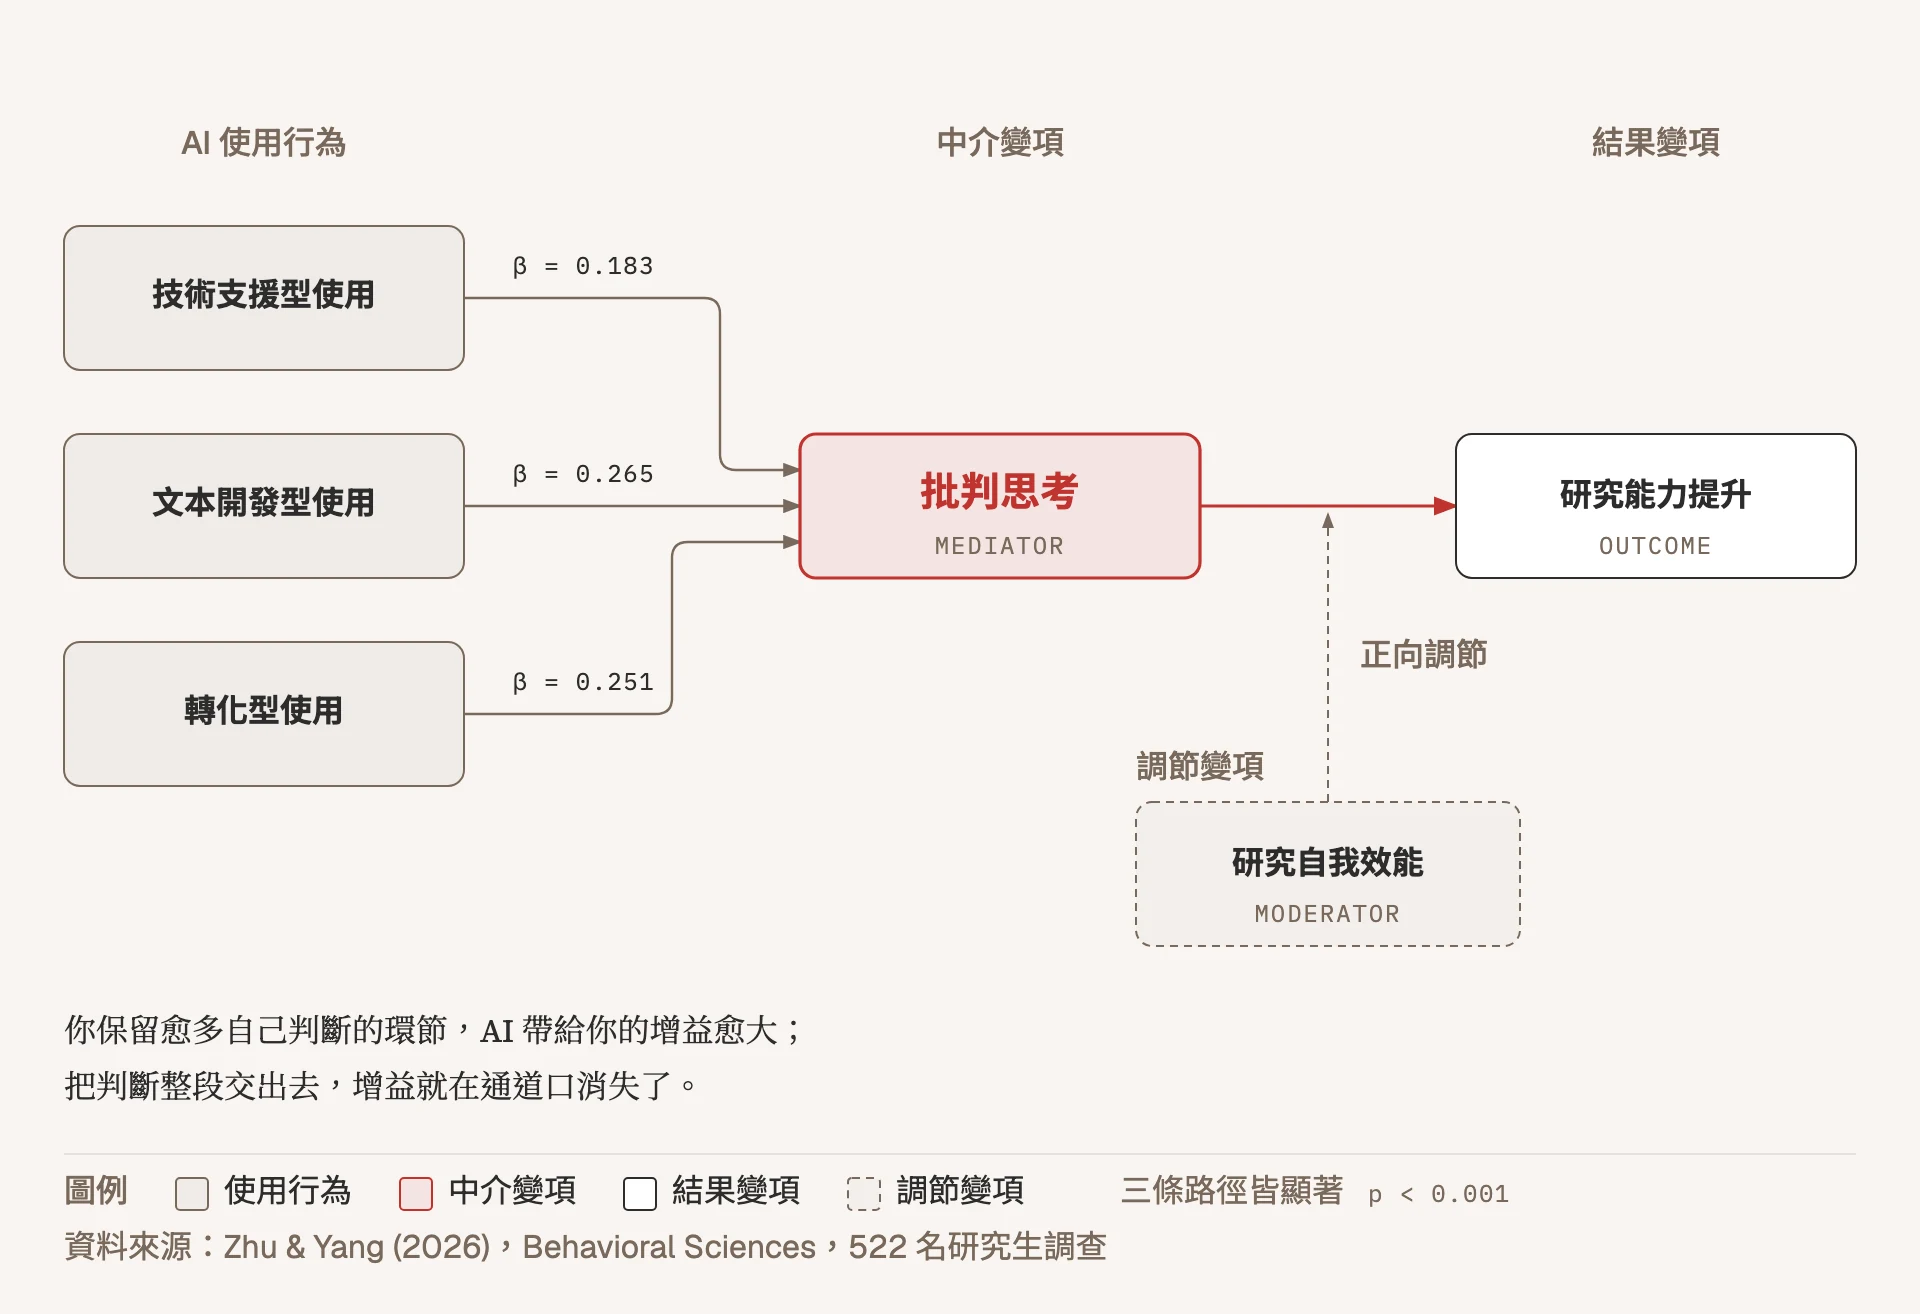
▲ 增益不是直接發生的,它要先經過批判思考這道關口。
美國華頓商學院的 Ethan Mollick 是前述 BCG 論文的共同作者,也是目前最積極主張教育體系擁抱 AI 的學者之一。他的立場可以概括成一句話:問題不在禁止,在重新設計。他主張把作業從「關於產出」改造成「關於學習」,並且明確引用了土耳其那個實驗來說明:無提示的 ChatGPT 像拐杖,但給學生一個帶基礎家教提示的版本,作業分數上升而期末考分數並沒有下降。
那條線該怎麼畫:三個判準
既有的那篇誠信文章,是按研究的五個環節逐一劃線(文獻、設計、分析、寫作、口試)。那是從外部規範出發的畫法。
這裡提供另一套畫法,從你自己的養成出發。不必背環節,只要對任何一段工作問以下三個問題:
第一題:這一步做完,留下來的是一份檔案,還是我身上多出來的一項判斷力?
把三十篇 PDF 的書目格式整理成 APA,做完留下的是一份檔案。把這三十篇讀過之後,看出其中有兩派人其實在吵同一件事的不同層次,做完留下的是判斷力。前者外包沒有損失,後者外包等於什麼都沒發生。
第二題:如果明天口試委員針對這個選擇追問我三輪,我答不答得出來?
注意是三輪,不是一輪。第一輪你可以複述 AI 給你的理由,第二輪開始就要靠自己了。凡是撐不過第二輪的地方,就是你其實沒有真的做過那個決定的地方。
第三題:如果下次沒有 AI,我還做不做得到?
這題直接對應土耳其實驗那個 17%。它不是要你苦行,而是一個誠實的體檢指標。做得到,代表 AI 是在加速你;做不到,代表 AI 正在替代你。
三題之中只要有一題答不出來,那一段就是你該自己走一遍的地方。
套進實際工作裡長這樣
外包出去,只是省時間的:
- 書目格式轉換、引用樣式套用
- 逐字稿的初步斷句與整理
- 關鍵字擴充、同義詞與檢索式建構
- 外文文獻的初步翻譯(但關鍵句要回原文確認)
- 程式碼的語法除錯與註解撰寫
- 把已經想好的內容改寫得更通順
外包出去,等於抵押自己養成的:
- 決定研究問題要問什麼
- 判斷兩篇結論衝突的文獻誰比較可信
- 決定用哪一種研究方法,以及為什麼
- 把概念操作化成可測量的指標
- 詮釋資料的意義(不是整理,是詮釋)
- 決定這份研究的貢獻要宣稱到什麼程度
中間還有一段模糊地帶,例如整理文獻之間的爭點、草擬分析架構。處理模糊地帶的原則是:先自己做一個簡單的版本,再讓 AI 挑戰它。順序一顛倒,效果就完全不同,這也是下一節第一條行動綱領的內容。
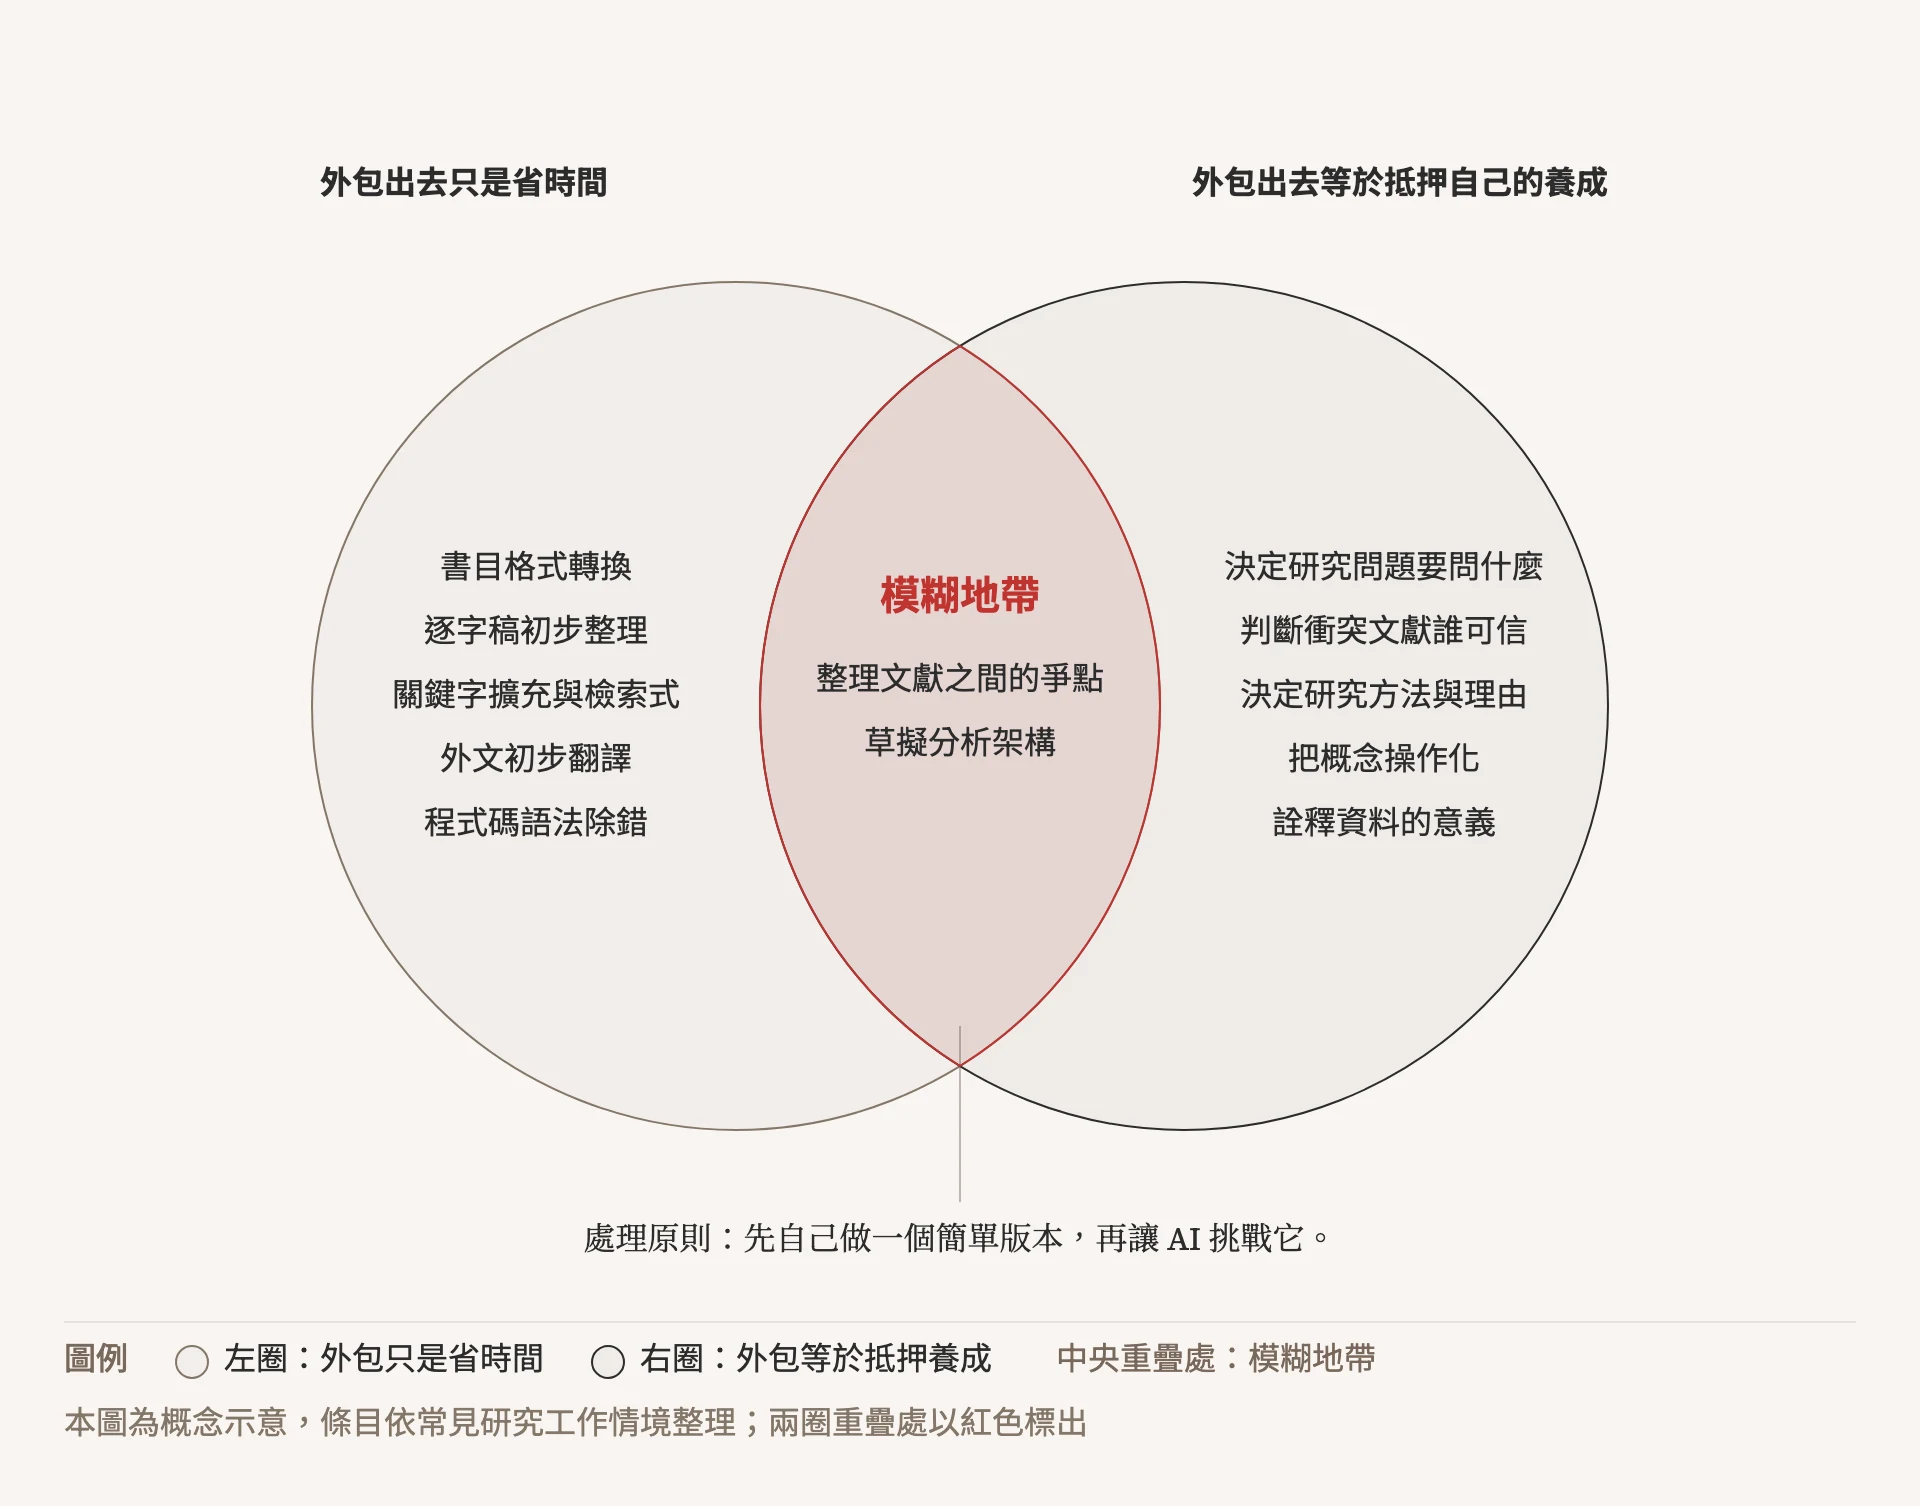
▲ 兩端都好判斷,真正要小心的是中間那塊。
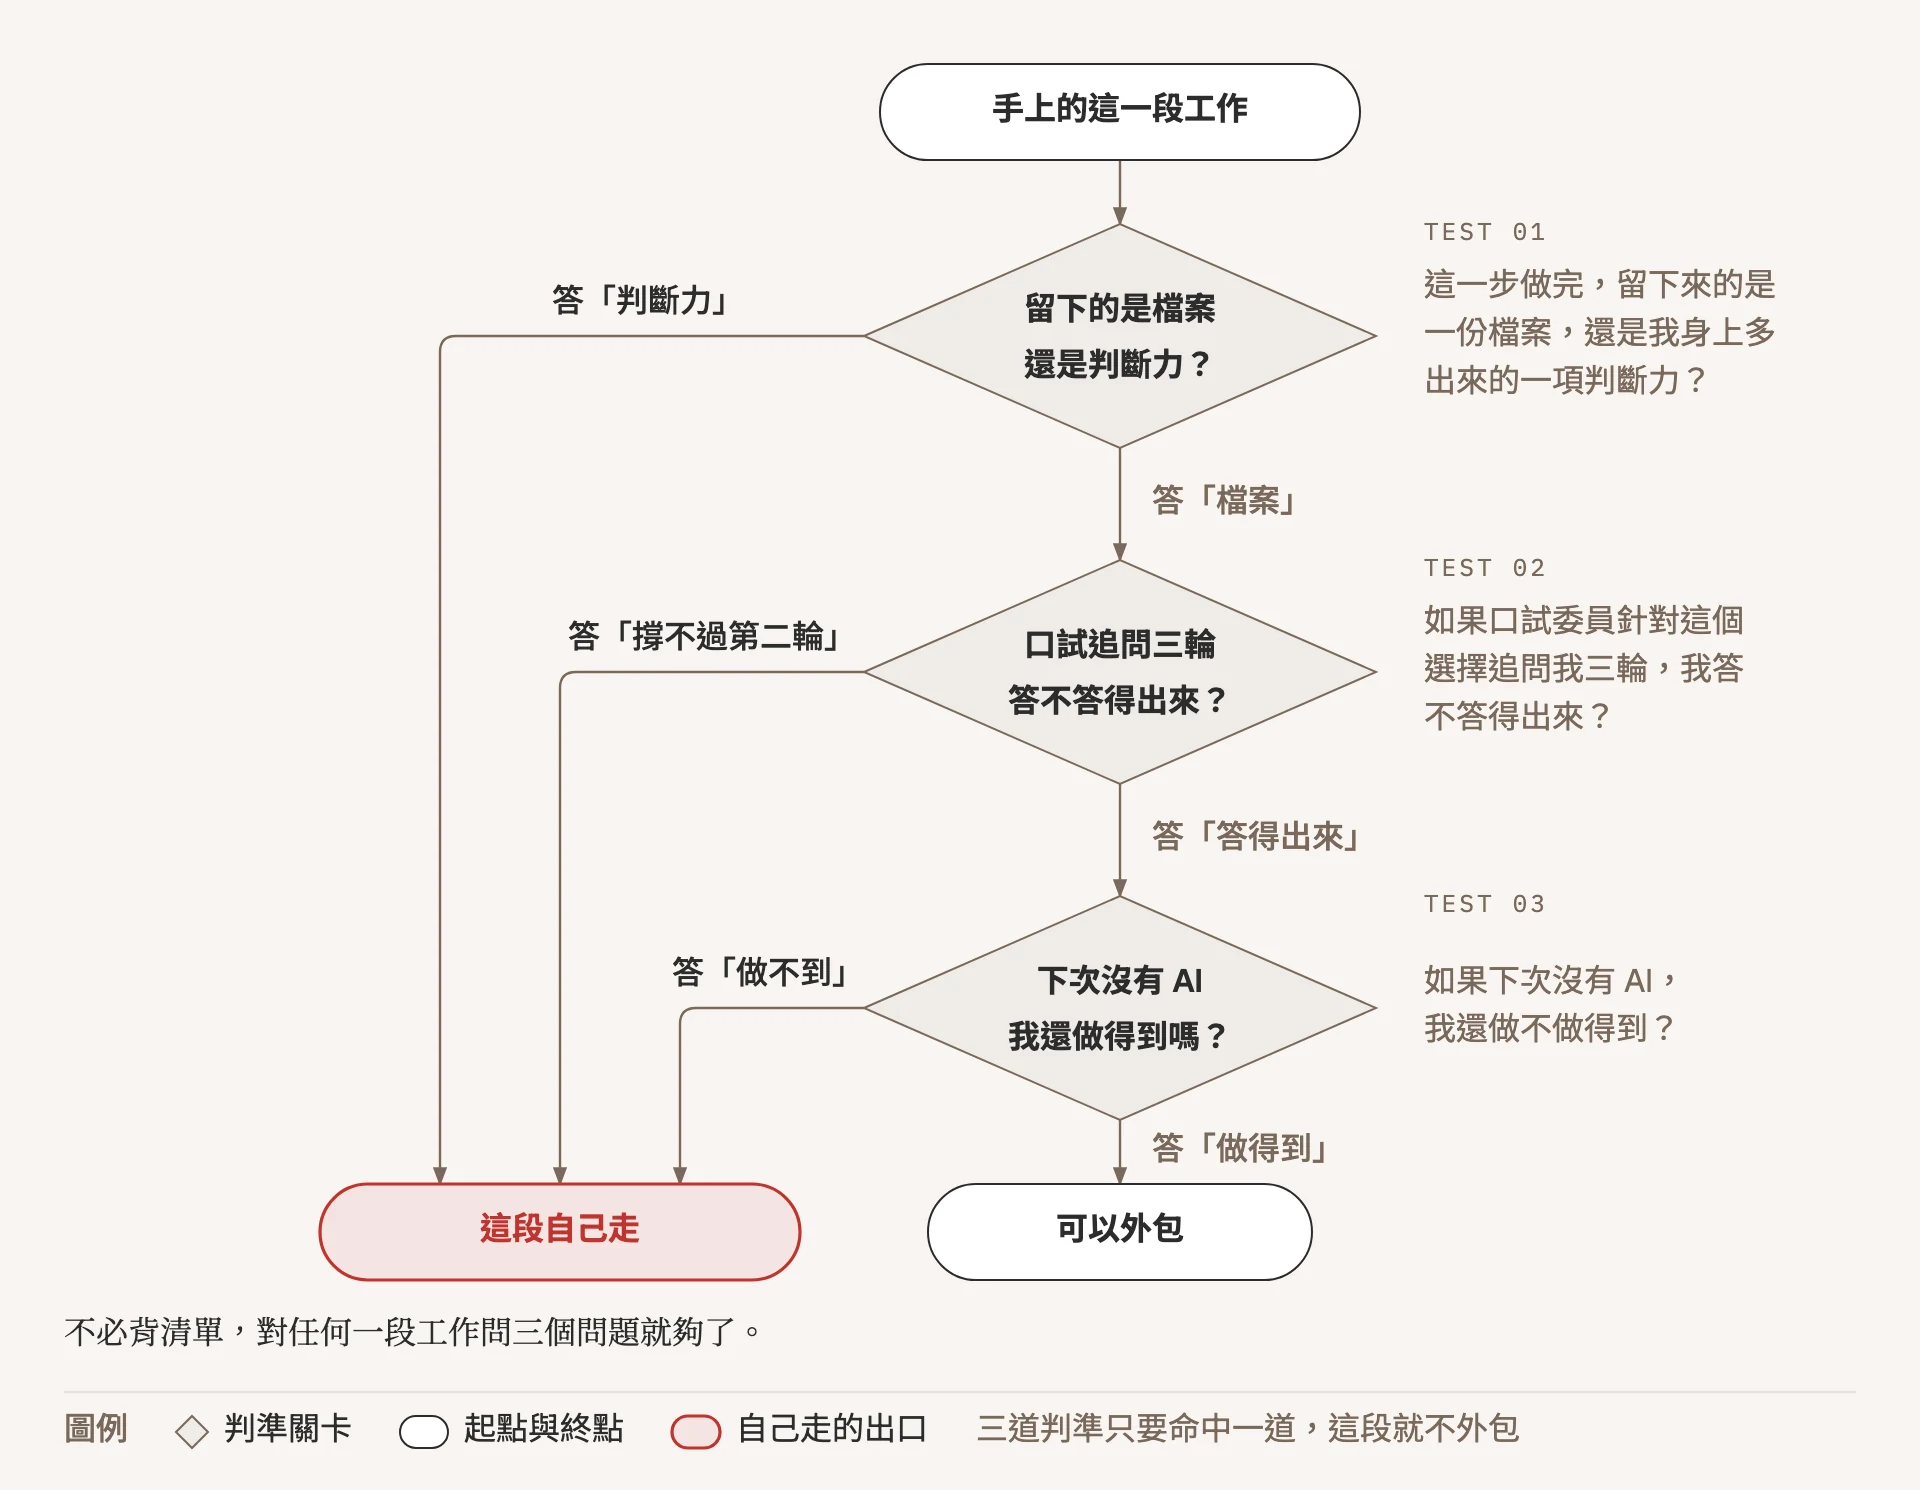
▲ 不必背清單,記住三個問題就夠了。
歐美日韓已經把話說到哪裡
值得注意的是,在我查到的資料裡,幾乎沒有一所頂尖大學選擇全面禁止。它們談的都是同一件事:責任不能外包。
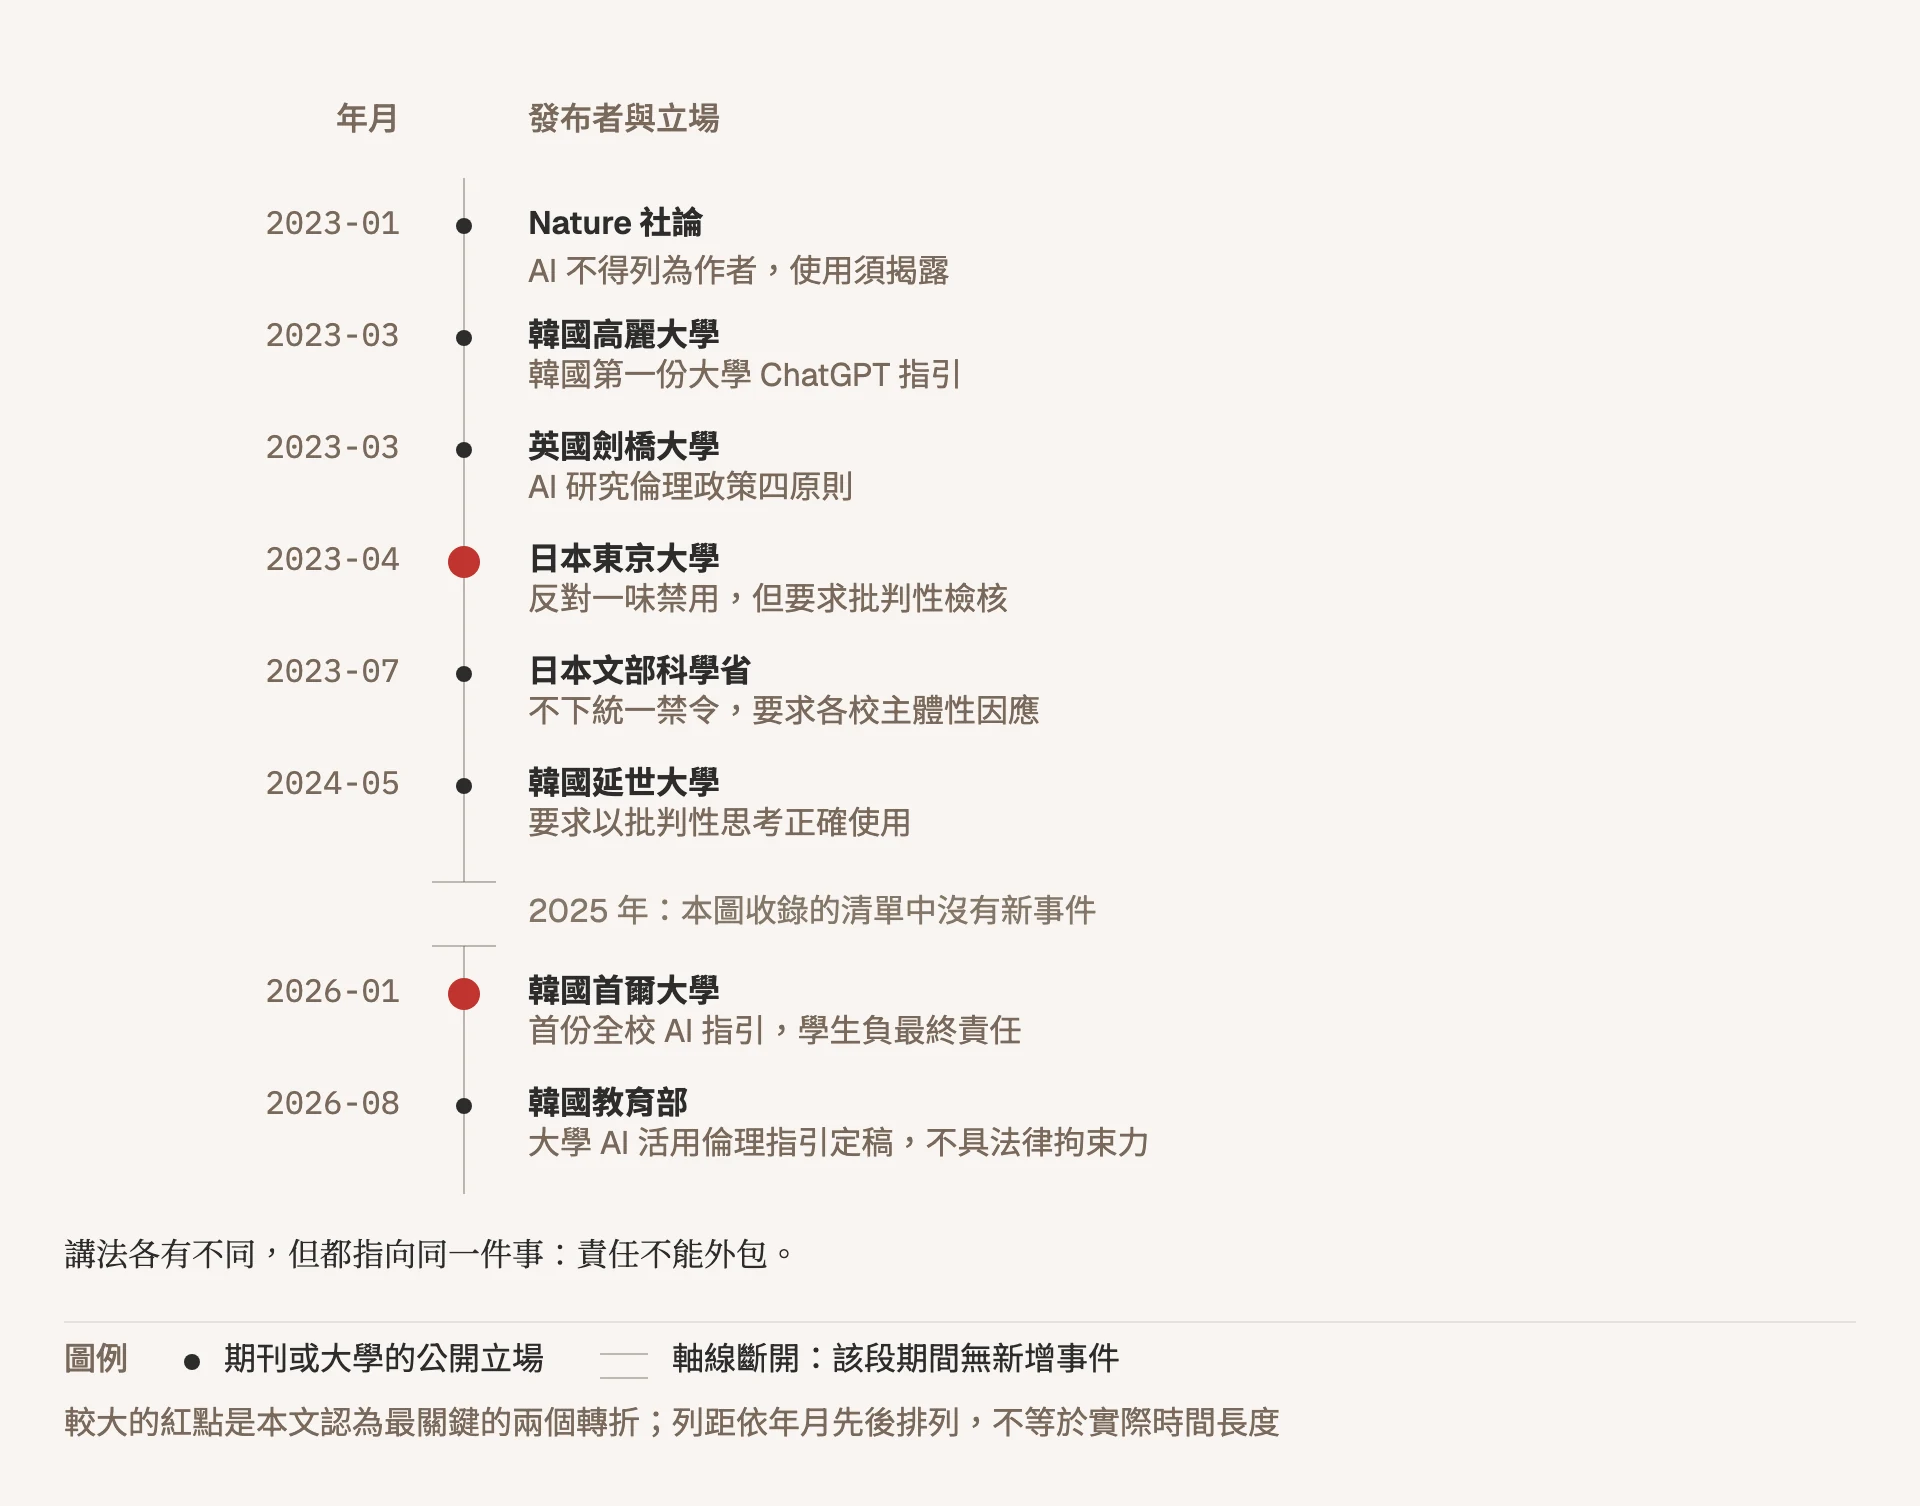
▲ 講法各有不同,但都指向同一件事:責任不能外包。
日本:教育要的不是結果,是過程中學到的東西
日本東京大學在 2023 年 4 月就由理事兼副學長太田邦史發布了全校性見解。他把生成式 AI 的衝擊比擬為重組 DNA 技術問世,明確反對一味禁用,主張大學應該主動找出好的用法與配套制度。但他同時寫下:
要駕馭 ChatGPT,需要相當程度的專業知識,必須批判性地檢核它的回答並適時修正。也就是說,不能因為 ChatGPT 出現了,人類自己就怠惰於學習與研究。
同月稍晚的課堂使用指引裡,還有一句更適合貼在研究室牆上的話:教育要的不是結果本身,而是在產出結果的過程中學到了什麼。該份指引明訂,整份複製貼上 AI 的答案「對學生毫無學習效果」,原則上不應允許。
日本京都大學校長湊長博在同年的入學典禮致詞裡,用了一組很漂亮的對比:search 與 research 的差別。他指出 AI 生成的文章欠缺「反覆查證」這道程序,無法正確指出論據來源,對學術報告而言是致命的問題。他給新生的期許是:希望各位養成花時間慢慢打磨自己文章的習慣。
日本文部科學省(MEXT)於 2023 年 7 月 13 日正式發布《關於大學及高等專門學校在教學面應對生成式 AI 的注意事項》指引。此方針的核心特色在於避免統一禁令,而是採取主體性因應與滾動式滾動檢討的開放態度。
韓國:可以用,但最終責任在你
高麗大學是韓國第一所發布 ChatGPT 指引的大學(2023 年 3 月)。基本方向不是阻擋,而是合理接納,具體做法包括多出需要實地蒐集與分析經驗資料的作業、要求學生詳述推導結論的整個過程,並由各科授課教師決定是否允許、寫進教學大綱。前面引過的那句「ChatGPT 產不出超越使用者自身實力的成果」,就是該校校長金東元說的。
延世大學 2024 年的指引強調使用者必須「透過自己的判斷與檢核,抱持負責任的倫理意識,以批判性思考正確使用」。首爾大學則在 2026 年初發布第一份全校 AI 指引,四項核心原則是透明性、正確性、個資與資安、問責,並明訂:學生可在教授允許的範圍內使用 AI 工具,但必須為該使用承擔最終責任。
韓國教育部與大學教育協議會在 2026 年推出的大學 AI 活用倫理指引,立場是「AI 已成為大學教育革新的必備工具,但其運用必須以明確的基準與倫理責任為前提」,並且明言不具法律拘束力。有個數字可以參考該國的實況:已訂相關規範的 56 所大學中,45 所明訂不得把個資或內部資料輸入生成式 AI,32 所訂有作業與報告的撰寫基準。
歐美:問責不能委外
期刊端的立場高度一致。Nature 早在 2023 年 1 月的社論就立下兩條規則:AI 不接受列為作者,使用 AI 必須在方法或誌謝段落載明。現行的 Nature Portfolio 政策把它寫成一句更硬的話:學術內容、評議與編輯決策的問責,不能外包給 AI 系統。
ICMJE 的說法是:聊天機器人不應列為作者,因為它們無法對作品的正確性、誠信與原創性負責;作者必須仔細檢核與編輯 AI 的產出,因為 AI 會生成聽起來很權威、實際上卻可能錯誤、不完整或有偏誤的內容。COPE 的立場聲明方向相同。
出版社端,劍橋大學出版社與評量(Cambridge University Press & Assessment)在 2023 年 3 月公布 AI 研究倫理政策,四條原則包括 AI 必須如同其他軟體與方法一樣被聲明、AI 不符合作者資格、使用須符合抄襲政策、作者對正確性與誠信負完全責任。
史丹佛大學的規則最好記,我認為也最適合研究生拿來自我檢查:
在課程教師沒有明確說明的情況下,使用或諮詢生成式 AI,應比照接受另一個人的協助來處理。
把這句話代進去想一遍,很多模糊地帶會瞬間清晰。請另一個人幫你把段落改通順,沒問題。請另一個人替你決定研究問題、替你寫完整章,那叫什麼,你心裡有數。
出事的時候,長什麼樣子
這幾年的實際案例,有一個共同點值得注意:出事的人多半不是想造假,他們只是省掉了最後那一次自己看過一遍的程序。
2024 年 2 月,一篇關於精原幹細胞的論文〈Cellular functions of spermatogonial stem cells in relation to JAK/STAT signaling pathway〉在 Frontiers 期刊上線,三張插圖全由 Midjourney 生成,其中一張老鼠解剖圖的生殖器大於身體本身,圖上的標示全是拼字亂碼。作者在文中其實有坦承圖由 AI 產生,審稿人也曾提出疑慮,但作者未回應,編輯仍然放行。上線三天後撤稿。
同年,另一篇刊在 Elsevier 旗下期刊的鋰電池論文,引言第一行原封不動留著「Certainly, here is a possible introduction for your topic」。另一篇醫學個案報告的結論段落,中間卡著一句「很抱歉,我是 AI 語言模型,無法取得即時資訊或特定病人資料」。
審稿端也沒有比較好。2025 年 7 月,日經亞洲掃出 17 篇 arXiv 預印本以白色字體或極小字級藏入給語言模型的指令,要求「只給正面評價」,涉及 8 國 14 所機構。同年 11 月,一項針對 ICLR 投稿的分析指出,7 萬則審稿意見中約 21% 被判定為完全由 AI 生成(這個數字來自偵測工具,會把人機協作誤判為全 AI,宜視為上界)。
規模上,2023 年全球撤稿通知首度突破一萬篇,創歷史新高。一項分析 1,500 萬篇 PubMed 摘要的研究推估,2024 年至少有 13.5% 的生醫摘要經過語言模型處理,部分子領域高達四成。
最後一個案例,是給研究生看的風險提示。2024 年 11 月,美國明尼蘇達大學一名健康經濟學博士生,在明文禁用 AI 的資格考中被四位評分教授判定使用 AI,遭到退學,並因此影響國際學生簽證。他否認,主張自己只用 ChatGPT 檢查英文,目前已提起聯邦訴訟。
這個案子還在訴訟中,尚未定讞,校方以偵測工具為主要證據的做法也備受質疑。但它揭示的風險是真的:在目前的環境裡,光是被指控,就足以讓你的學業停擺。而你能提出的最有力辯護,從來不是「我沒有用」,而是你留得下完整的思考軌跡。
七條行動綱領
前面都是分析,這一節是可以直接照做的。
一、先寫一個比較簡單的版本,再開 AI。
任何需要動腦的工作,先自己寫出一個粗糙、不完整、甚至有點丟臉的版本,再把它交給 AI。這一條的理論基礎是生成效應:自己生成的內容,記得比被動接收的牢。更實際的好處是,你手上有了底稿,才有東西可以跟 AI 的建議做比對,否則你只能全盤接受。
爛版本的門檻訂低一點。一段話、三個條列、一張塗鴉都算數。重點是順序,不是品質。
二、把 AI 放在審稿人的位置,不要放在作者的位置。
同一個工具,換個位置,效果天差地遠。實際可以這樣用:把你的研究問題丟給它,請它列出三個最可能被口試委員攻擊的弱點;把你的方法章丟給它,請它以目標期刊審稿人的身分寫一封拒稿信;把你的文獻回顧丟給它,請它指出哪些段落只是在排隊報告、沒有整理出爭點。
它挑你毛病的價值,遠大於它替你生產。而且這種用法完全不影響誠信,因為最後站上臺回答的還是你。
三、採納任何 AI 判斷之前,先寫兩行字。
這一條有實驗證據支撐,而且效果驚人。2026 年一項針對 342 名大學生的三組實驗發現:沒有任何提示時,受試者接受錯誤 AI 建議的比例是 62.4%;只要在採納前加入一個元認知反思的提示步驟,比例就降到 39.7%,覺察校準度從 0.41 提升到 0.59。
做法非常簡單,在你要採用 AI 的任何一個判斷之前,寫下兩行:
- 它給的理由是什麼?
- 我自己原本的判斷是什麼,兩者差在哪裡?
光是強迫自己把這兩行寫出來,就攔下了將近一半的錯誤。這大概是本文投資報酬率最高的一條。
四、每週留一個不用 AI 的時段。
一週一次,兩小時起跳,關掉所有 AI 工具,做一件核心的研究工作:精讀一篇文獻、手寫一段論證、自己重跑一次分析。
這不是苦行,是刻意替自己安排的有益困境。Bjork 夫婦那句話值得再看一次:當下的表現不是學習的可靠指標。這兩個小時的產出一定比較少,但它量的不是產出。
五、用延遲自測檢查自己是不是真的懂了。
讀完一篇重要文獻的隔天,不要看筆記,直接寫三句話:這篇在跟誰對話、主張什麼、用什麼證據。寫得出來,代表它進去了;寫不出來,代表你昨天讀的其實是 AI 的摘要,不是這篇文獻。
這一招來自提取練習的研究,也是最快拆穿「理解的錯覺」的方法。
六、替每一段外包留下還原點。
養成一個習慣:凡是有 AI 介入的段落,在你的研究日誌裡留下三件事,我問了什麼、它給了什麼、我改了什麼與為什麼改。
這件事有兩個用途。近的用途是揭露:多數期刊與學校的要求,濃縮起來就是你必須能解釋研究裡受惠於 AI 的每一個部分。遠的用途是自保:真的遇到前面那種被指控的情況,完整的思考軌跡是你唯一拿得出來的證據。
七、每學期做一次拿掉 AI 的體檢。
每個學期找一天,挑一份你這學期做過、有 AI 參與的工作,在沒有任何 AI 的情況下重做一遍其中最關鍵的一小段。可能是重新論證一個選擇,可能是重新詮釋一組資料。
比對兩次的結果。如果差距很大,那不是要你自責,而是一張很有用的體檢報告,它告訴你哪一塊肌肉這學期沒有練到。下學期就從那裡補。
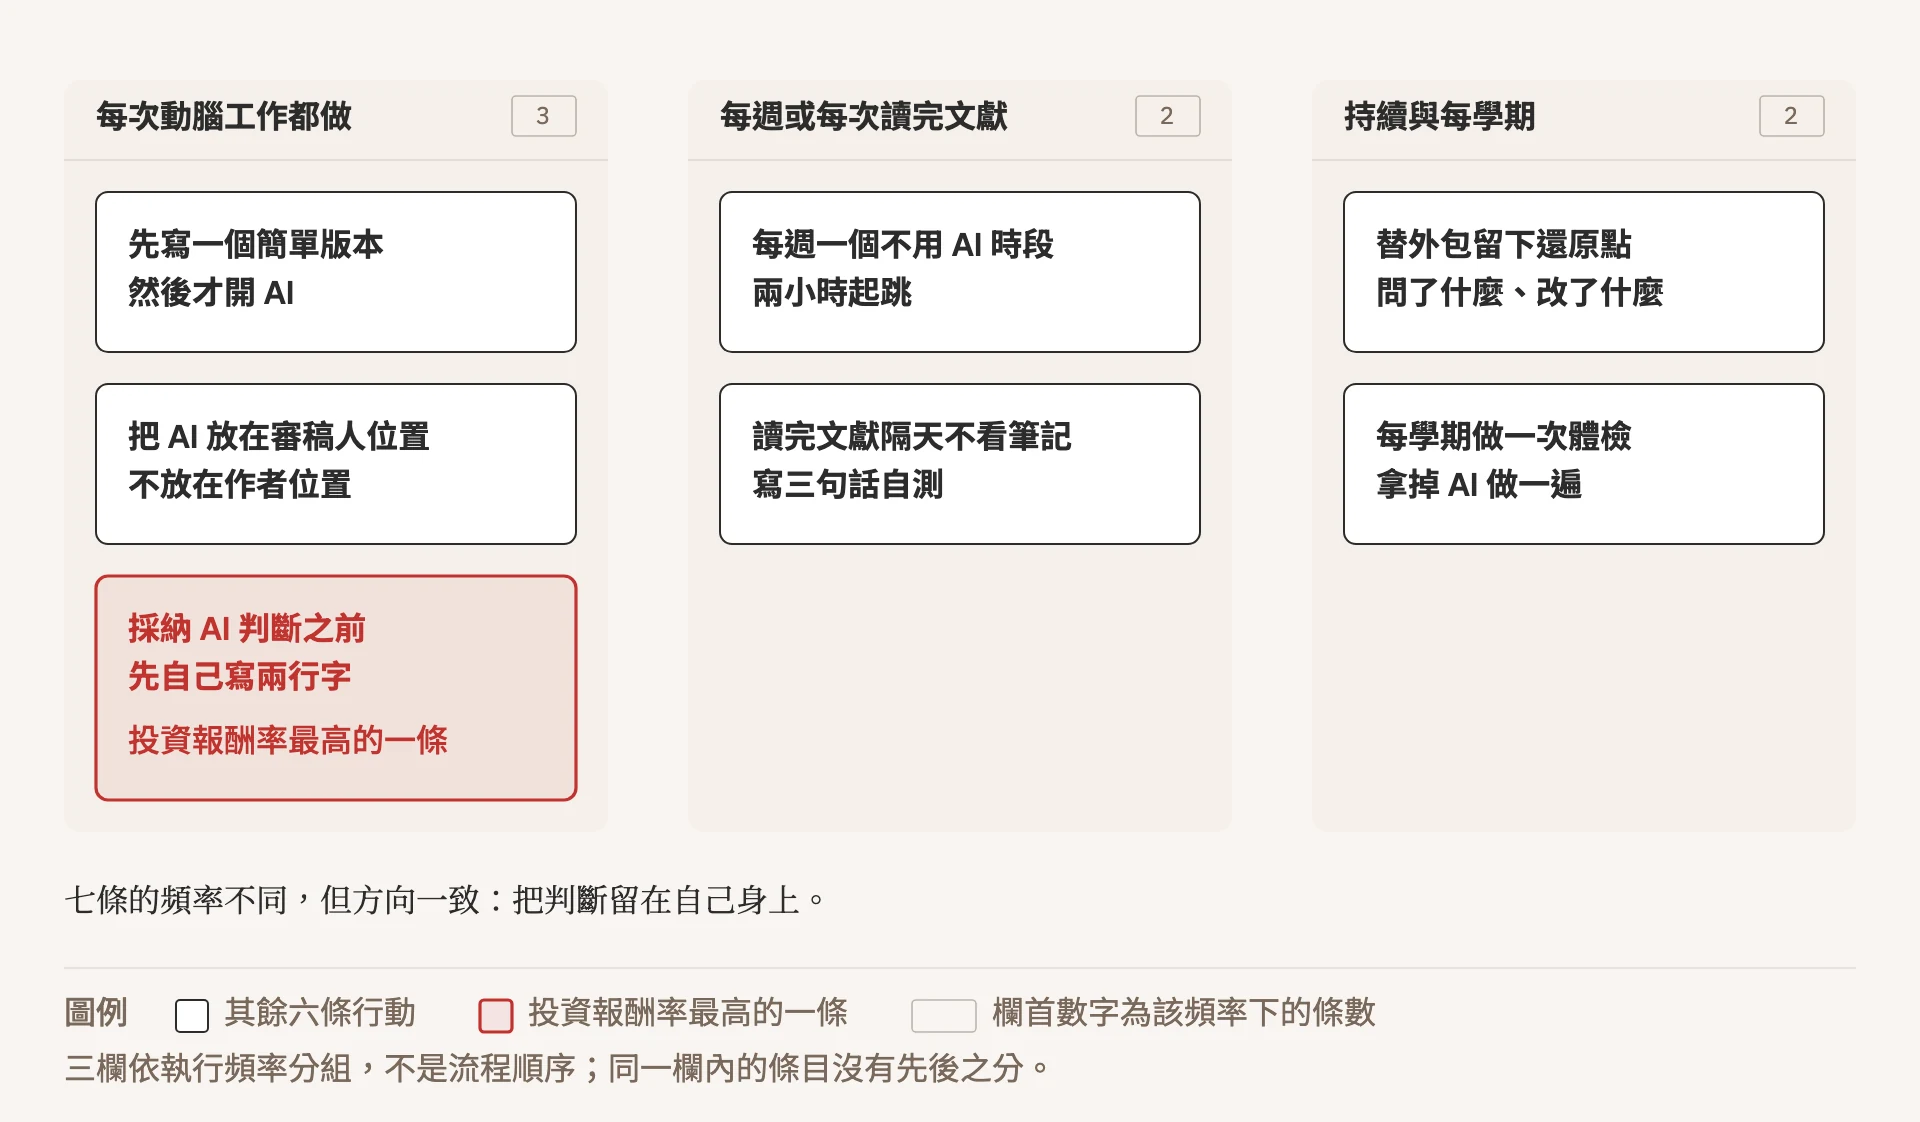
▲ 七條的頻率不同,但方向一致:把判斷留在自己身上。
思考沒有消失,它換了位置
前面引用的那篇 Microsoft Research 與美國卡內基美隆大學的調查,還有一個發現特別值得當作這篇文章的收尾。
研究者觀察到,使用生成式 AI 之後,投入批判思考的力氣並沒有減少,而是換了位置:從資訊蒐集轉向資訊查證,從解決問題轉向整合 AI 的回應,從執行任務轉向監管任務。
這個發現其實是好消息,但前提是你要跟著換位置。
如果你還停在「AI 幫我做完了,我看一下沒問題就收」的模式,那你既沒有做原來那件事,也沒有做新出現的那件事,兩邊都落空。查證、整合、監管,這三件事都比原本的工作更難,因為它們要求你在沒有標準答案的情況下判斷一份看起來很完整的東西哪裡不對。
而要做得到這件事,你需要的恰恰是那些不能外包的訓練。
Mewburn 教授的那句話之所以有力,不是因為它禁止了什麼。它只是提醒了一個容易被進度壓力蓋過去的事實:研究所發給你的,是一個人的資格,不是一份文件的資格。論文會被歸檔,會被引用,也可能幾年後就沒人讀了。但那個學會怎麼提問、怎麼懷疑、怎麼為自己的判斷辯護的人,會一直是你。
今天就可以做的一件事
打開你手上正在寫的檔案,找出最近一段有 AI 參與的內容。
先問自己:如果口試委員針對這一段追問三輪,我撐得到第幾輪?
然後做一件小事,用第三條那個方法,寫下兩行字:AI 當時給的理由是什麼,我自己原本的判斷又是什麼?
如果第二行寫不出來,恭喜你,你剛剛找到了這學期最值得自己好好思考、重來一遍的那一段。
延伸資源
- 研究生該怎麼用 AI 才不踩線:守住學術誠信的實戰指南
- 用了 AI 不可恥,藏起來才有風險
- 別再叫 AI 幫你整理論文主題
- 研究生生存指南:把研究做完,更要把自己找回來
- 讀研究所的方法論:七個名人的自述與訪談
- 參考書單:研究方法、學術生涯
參考文獻
- Mewburn, I. (2026). The ‘P’ in PhD does not stand for ‘prompt’. The Thesis Whisperer. https://thesiswhisperer.com/2026/06/18/the-p-in-phd-does-not-stand-for-prompt/
- Nordling, L. (2026). AI and the PhD student: friend or foe? Nature. https://www.nature.com/articles/d41586-026-00843-y
- Bastani, H., Bastani, O., Sungu, A., Ge, H., Kabakcı, Ö., & Mariman, R. (2025). Generative AI without guardrails can harm learning: Evidence from high school mathematics. PNAS, 122(26). https://www.pnas.org/doi/10.1073/pnas.2422633122
- Kosmyna, N., et al. (2025). Your Brain on ChatGPT: Accumulation of Cognitive Debt when Using an AI Assistant for Essay Writing Task(預印本,未經同儕審查). arXiv:2506.08872. https://arxiv.org/abs/2506.08872
- Gerlich, M. (2025). AI Tools in Society: Impacts on Cognitive Offloading and the Future of Critical Thinking. Societies, 15(1), 6(相關研究,非因果;另有 2025 年 9 月更正). https://www.mdpi.com/2075-4698/15/1/6
- Lee, H.-P., Sarkar, A., Tankelevitch, L., Drosos, I., Rintel, S., Banks, R., & Wilson, N. (2025). The Impact of Generative AI on Critical Thinking. CHI ‘25. https://www.microsoft.com/en-us/research/wp-content/uploads/2025/01/lee_2025_ai_critical_thinking_survey.pdf
- Bjork, E. L., & Bjork, R. A. (2023). Introducing Desirable Difficulties Into Practice and Instruction. In In Their Own Words. APA Division 2. https://www.unh.edu/teaching-learning-resource-hub/sites/default/files/media/2023-06/itow-introducing-desirable-difficulties-into-practice-and-instruction-bjork-and-bjork.pdf
- Roediger, H. L., & Karpicke, J. D. (2006). Test-Enhanced Learning. Psychological Science, 17(3), 249-255. https://doi.org/10.1111/j.1467-9280.2006.01693.x
- Slamecka, N. J., & Graf, P. (1978). The generation effect. JEP: Human Learning and Memory, 4(6), 592-604. https://doi.org/10.1037/0278-7393.4.6.592
- Risko, E. F., & Gilbert, S. J. (2016). Cognitive Offloading. Trends in Cognitive Sciences, 20(9), 676-688. https://doi.org/10.1016/j.tics.2016.07.002
- Dell’Acqua, F., et al. (2023). Navigating the Jagged Technological Frontier. HBS Working Paper 24-013. https://mitsloan.mit.edu/sites/default/files/2023-10/SSRN-id4573321.pdf
- Noy, S., & Zhang, W. (2023). Experimental evidence on the productivity effects of generative artificial intelligence. Science, 381(6654), 187-192. https://doi.org/10.1126/science.adh2586
- Ren, S. (2026). College students’ metacognitive awareness of generative-AI reliance. Frontiers in Psychology. https://www.frontiersin.org/journals/psychology/articles/10.3389/fpsyg.2026.1926110/full
- Zhu, H., & Yang, S. (2026). The Impact of Generative AI Use on Graduate Students’ Research Competence. Behavioral Sciences. https://pmc.ncbi.nlm.nih.gov/articles/PMC12937814/
- Kobak, D., González-Márquez, R., Horvát, E.-Á., & Lause, J. (2025). Delving into LLM-assisted writing in biomedical publications. Science Advances, 11(27). https://www.science.org/doi/10.1126/sciadv.adt3813
- 太田邦史(2023)。〈生成系AIについて〉。東京大學。
- 東京大學(2023)。〈AIツールの授業における利用について〉。
- 湊長博(2023)。〈令和5年度学部入学式 式辞〉。京都大學。
- 高麗大學校(2023)。〈ChatGPT 活用指引〉。
- 首爾大學校(2026)。〈서울대학교 AI 가이드라인〉。
- Nature Portfolio. Artificial Intelligence (AI) editorial policies. https://www.nature.com/nature-portfolio/editorial-policies/ai
- ICMJE. Defining the Role of Authors and Contributors(查閱於 2026-09-22). https://www.icmje.org/recommendations/browse/roles-and-responsibilities/defining-the-role-of-authors-and-contributors.html
- Stanford University Office of Community Standards. Generative AI Policy Guidance. https://communitystandards.stanford.edu/generative-ai-policy-guidance
- Cambridge University Press & Assessment (2023). Cambridge launches AI research ethics policy. https://www.cambridge.org/news-and-insights/cambridge-launches-ai-research-ethics-policy
常見問題
「博士的 P 不是 prompt」這句話出自哪裡?
出自澳洲國立大學研究人員發展總監 Inger Mewburn 教授在 2026 年 6 月 18 日發表於個人部落格 The Thesis Whisperer 的同名文章。值得注意的是,她並不是反對 AI 的人,她在同一篇文章裡坦承自己重度使用 Gemini Notebook 做文獻回顧,每週至少省下十二小時。她真正要講的是一個區別:她已經具備判斷 AI 輸出好壞的專業能力,而博士生正在長出那個能力的過程中,兩者能承受的外包程度不一樣。
用 AI 幫忙做研究,真的會傷害我的能力養成嗎?
有實驗證據指向會,但關鍵在於怎麼用。發表於 PNAS 的土耳其高中數學田野實驗最值得參考:學生使用一般介面的 GPT-4 時,當下成績提升 48%,可是一旦把 AI 拿掉,這組學生的表現比從未接觸 AI 的對照組還低 17%。研究者形容學生把它當成練習時的拐杖。但同一個實驗裡,另一組使用加了學習防護欄的版本(只給引導提示、不直接給答案),成績提升 127%,而且拿掉 AI 之後的負面效果被大幅消除。所以決定結果的不是用不用 AI,而是你讓它替你做了哪一段。
哪些研究工作可以交給 AI,哪些不行?
與其背一張工具清單,不如記住三個判準。第一,這一步做完之後,留下來的是一份檔案,還是我身上多出來的一項判斷力?第二,如果明天口試委員針對這個選擇追問我三輪,我答不答得出來?第三,如果下次沒有 AI,我還做不做得到?三題裡只要有一題答不出來,那一段就是你該自己走一遍的地方。跑腿性質的工作(格式整理、初步翻譯、關鍵字擴充、逐字稿整理)外包出去只是省時間,但提出問題、判斷證據、決定研究設計、為選擇辯護這幾件事,外包出去等於把自己的養成一併抵押掉。
有沒有一個簡單的方法,可以避免自己盲信 AI 的答案?
有,而且效果經過實驗檢驗。2026 年發表於 Frontiers in Psychology 的一項研究找了 342 名大學生分三組做決策,結果顯示:在沒有任何提示的情況下,受試者接受錯誤 AI 建議的比例高達 62.4%;但只要在採納前加入一個元認知反思的提示步驟,這個比例就降到 39.7%,覺察校準度也從 0.41 提升到 0.59。做法很簡單,在你要採納 AI 的任何一個判斷之前,先寫下兩行字:它的理由是什麼,以及我自己原本的判斷是什麼。光是強迫自己把這兩行寫出來,就能攔下將近一半的錯誤。
各國大學到底禁不禁止研究生使用生成式 AI?
幾乎沒有一所頂尖大學選擇全面禁止,共通的立場是責任不能外包。日本東京大學早在 2023 年就明確反對一味禁用,但同時指出「教育要的不是結果本身,而是在產出結果的過程中學到了什麼」。韓國高麗大學是韓國第一所發布指引的大學,校長金東元的說法是「ChatGPT 產不出超越使用者自身實力的成果」。美國史丹佛大學則訂出一條很好記的規則:在課程教師沒有明確說明的情況下,使用生成式 AI 應比照接受另一個人的協助來處理。期刊端也一致,Nature、ICMJE 與 COPE 都認定 AI 不能掛名作者,因為它無法為正確性與誠信負責。